 Cesar Schutz
Quando uma empresa quer analisar os próprios dados, a pergunta aparece cedo: guardar tudo já organizado em tabelas, pronto para relatório, ou guardar tudo do jeito que chega e decidir depois? A primeira resposta é o Data Warehouse; a segunda, o Data Lake. Este post compara os dois, explica as ideias por trás da diferença (schema-on-write x schema-on-read, ETL x ELT), mostra por que costumam trabalhar juntos e onde entra o Lakehouse.
As duas arquiteturas#
Data Warehouse (DW) é um banco otimizado para análise. Recebe dados estruturados (tabelas relacionais), vindos de sistemas transacionais e aplicações de negócio, já limpos e transformados para servir de “versão oficial” da informação. É a base de relatórios e dashboards de BI (business intelligence).
Data Lake é um repositório central que guarda dados brutos em qualquer formato: estruturados (tabelas), semiestruturados (como JSON) e não estruturados (imagens, áudio, documentos). Em geral fica em armazenamento de objetos barato, como Amazon S3, e atende exploração de dados, machine learning e big data.
Schema-on-write x schema-on-read#
Schema é a estrutura do dado: quais campos existem e de que tipo são. A grande diferença entre as duas arquiteturas é quando essa estrutura é definida.
- Schema-on-write (DW): a estrutura é definida antes de gravar. Todo dado que entra precisa caber nela.
- Schema-on-read (Data Lake): o dado é gravado como chegou, e a estrutura é aplicada na hora da leitura, por quem vai consultar.
Um exemplo: o sistema de pedidos passa a enviar um campo novo, cupom. No DW, a tabela pedidos precisa ganhar a coluna cupom (e a carga precisa ser ajustada) antes que esse dado possa ser gravado. No Data Lake, o arquivo JSON com o campo novo é salvo como está; quem quiser analisar cupons declara o campo na consulta.
O preço da flexibilidade é que a qualidade e a governança do dado ficam para depois: sem cuidado, ninguém sabe mais o que está guardado no lake nem se dá para confiar. A fronteira também não é rígida: alguns DWs modernos aceitam schema-on-read em parte dos dados.
ETL x ELT#
Os dois nomes descrevem a ordem das etapas de um pipeline de dados:
- ETL (Extract, Transform, Load): extrai da origem, transforma em um servidor intermediário e só então carrega no destino. É o modelo clássico dos DWs.
- ELT (Extract, Load, Transform): extrai, carrega o dado como está e transforma depois, conforme a necessidade de análise. É o modelo natural do Data Lake.
Com a nuvem, o ELT virou o padrão também em muitos DWs: o dado é carregado primeiro e transformado dentro do próprio warehouse, que tem capacidade de processamento para isso.
O comparativo#
| Data Warehouse | Data Lake | |
|---|---|---|
| Dados | Estruturados (relacionais) | Qualquer formato: estruturado, semiestruturado e não estruturado |
| Schema | Definido antes de gravar (on-write) | Definido na leitura (on-read) |
| Processamento | ETL clássico; na nuvem, ELT é comum | ELT: grava bruto, transforma depois |
| Qualidade do dado | Curado, “versão oficial” | Bruto, curado ou não |
| Usuários típicos | Analistas de negócio, cientistas e desenvolvedores de dados | Cientistas, engenheiros e arquitetos de dados; analistas usam a parte curada |
| Custo e desempenho | Consultas mais rápidas, armazenamento mais caro | Armazenamento de baixo custo; consultas melhorando com a separação entre computação e armazenamento |
| Exemplos | Amazon Redshift, Google BigQuery, Snowflake | Amazon S3, Azure Data Lake Storage, Google Cloud Storage |
Por que costumam trabalhar juntos#
Na prática, a pergunta raramente é “um ou outro”. Uma arquitetura muito comum nas empresas tem duas camadas: todo o dado bruto vai para o Data Lake, que funciona como camada de ingestão e histórico completo, e um subconjunto curado segue por ELT para o Data Warehouse, que atende o BI. Times de machine learning e exploração leem direto do lake, onde está o dado completo.
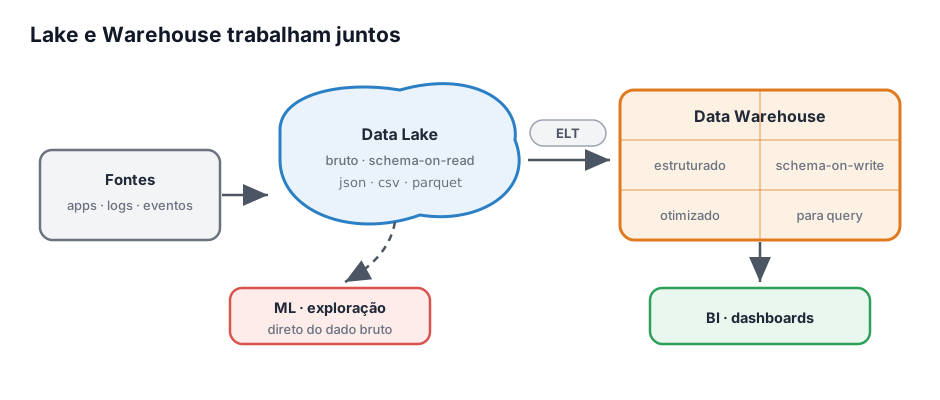
Essa divisão funciona, mas tem custo:
- Dado duplicado: o que vai para o DW é armazenado (e pago) duas vezes.
- Mais pipelines: cada etapa de ETL/ELT entre lake e warehouse é mais um ponto de falha e de divergência entre os dois sistemas.
- Dado defasado: o DW só vê o dado depois da carga, que muitas vezes leva dias.
Onde entra o Lakehouse#
O Lakehouse ataca exatamente esses problemas. A ideia é manter uma única cópia dos dados no armazenamento barato do lake, em formatos abertos de arquivo (como Apache Parquet), e acrescentar por cima uma camada de metadados que dá aos arquivos recursos típicos de um warehouse.
Essa camada é o que se chama de table format (formato de tabela). Os mais conhecidos são o Delta Lake e o Apache Iceberg. Eles registram quais arquivos formam cada versão de uma tabela e, com isso, oferecem:
- Transações ACID: uma escrita entra inteira ou não entra, e quem lê nunca vê uma escrita pela metade.
- Versões e time travel: é possível consultar a tabela como ela estava em um momento anterior, para auditoria ou para desfazer uma carga errada.
- Controle de schema: o Delta Lake rejeita gravações fora do schema da tabela, e os dois permitem evoluir o schema (no Iceberg, adicionar ou renomear colunas não exige reescrever a tabela).
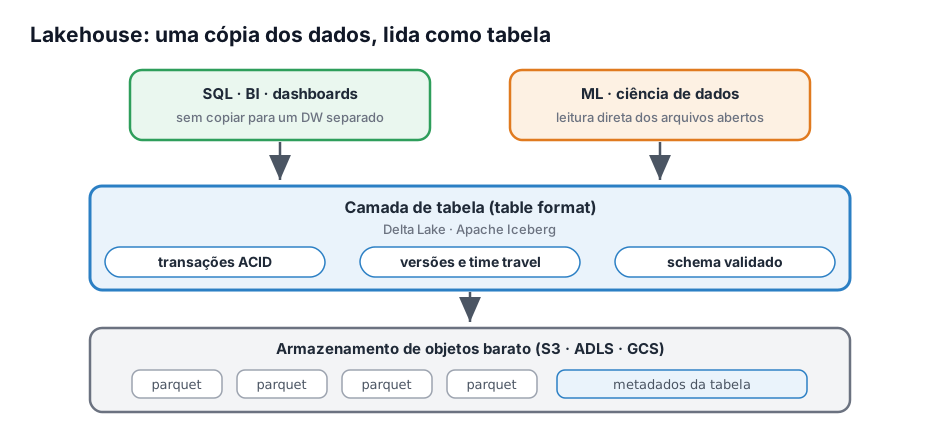
Assim, BI e machine learning leem as mesmas tabelas, sem copiar dados para um warehouse separado. Um cuidado: o Lakehouse não elimina o trabalho de curadoria. Ainda é preciso escrever ETL/ELT para transformar dado bruto em dado confiável; a diferença é que há menos etapas e menos cópias.
Resumo prático#
- Data Warehouse: dado curado e estruturado, pronto para BI. Escolha quando o foco é relatório confiável e consultas SQL rápidas.
- Data Lake: tudo o que chega, bruto e barato. Escolha quando o volume e a variedade são grandes, ou quando há exploração e machine learning.
- Os dois juntos: o arranjo clássico, com o lake como ingestão e histórico e o DW como camada de consumo, ao custo de dados duplicados e mais pipelines.
- Lakehouse: uma cópia só, no lake, com transações, versões e schema controlado por um table format. Vale avaliar quando a duplicação e a defasagem entre lake e warehouse viraram problema.
Fontes#
- AWS — What is a Data Lake?
- AWS — Data Warehouse vs. Data Lake vs. Data Mart
- AWS — ETL vs. ELT
- Armbrust, Ghodsi, Xin e Zaharia — Lakehouse: A New Generation of Open Platforms that Unify Data Warehousing and Advanced Analytics (CIDR 2021)
- Databricks — What is a Data Lakehouse?
- Delta Lake — Site oficial
- Apache Iceberg — Site oficial e especificação do formato de tabela
- Microsoft Learn — Azure Data Lake Storage overview
- Google Cloud — BigQuery overview