 Cesar Schutz
Quando duas requisições leem a mesma linha, calculam um valor novo e gravam, uma delas pode apagar o trabalho da outra sem erro nenhum. Este post mostra as duas formas clássicas de impedir isso, o bloqueio otimista (detectar o conflito) e o bloqueio pessimista (evitar o conflito), com SQL testado no PostgreSQL 17 e o equivalente em Spring Data JPA. No fim, há um critério para escolher entre os dois e um terceiro caminho que muitas vezes dispensa ambos: o UPDATE condicional.
O tema aparece de raspão no artigo sobre cobrança duplicada no retry, como alternativa à restrição única. Aqui ele ganha o espaço que merece.
1. O problema que os dois resolvem#
Os dois existem para o mesmo defeito, que tem nome: lost update, a atualização perdida.
Dois clientes leem a mesma linha, cada um calcula um valor novo a partir do que leu, e os dois gravam. A segunda gravação sobrescreve a primeira, e a primeira desaparece sem erro nenhum. O saldo fica errado e o log está limpo.
É a mesma família do problema de cobrança duplicada no retry: ler, decidir e gravar como operações separadas, com uma janela no meio. Lá, a solução foi uma restrição única, que funciona quando a decisão cabe numa chave. Aqui o caso é outro: a decisão depende do valor lido, e não existe chave que expresse isso.
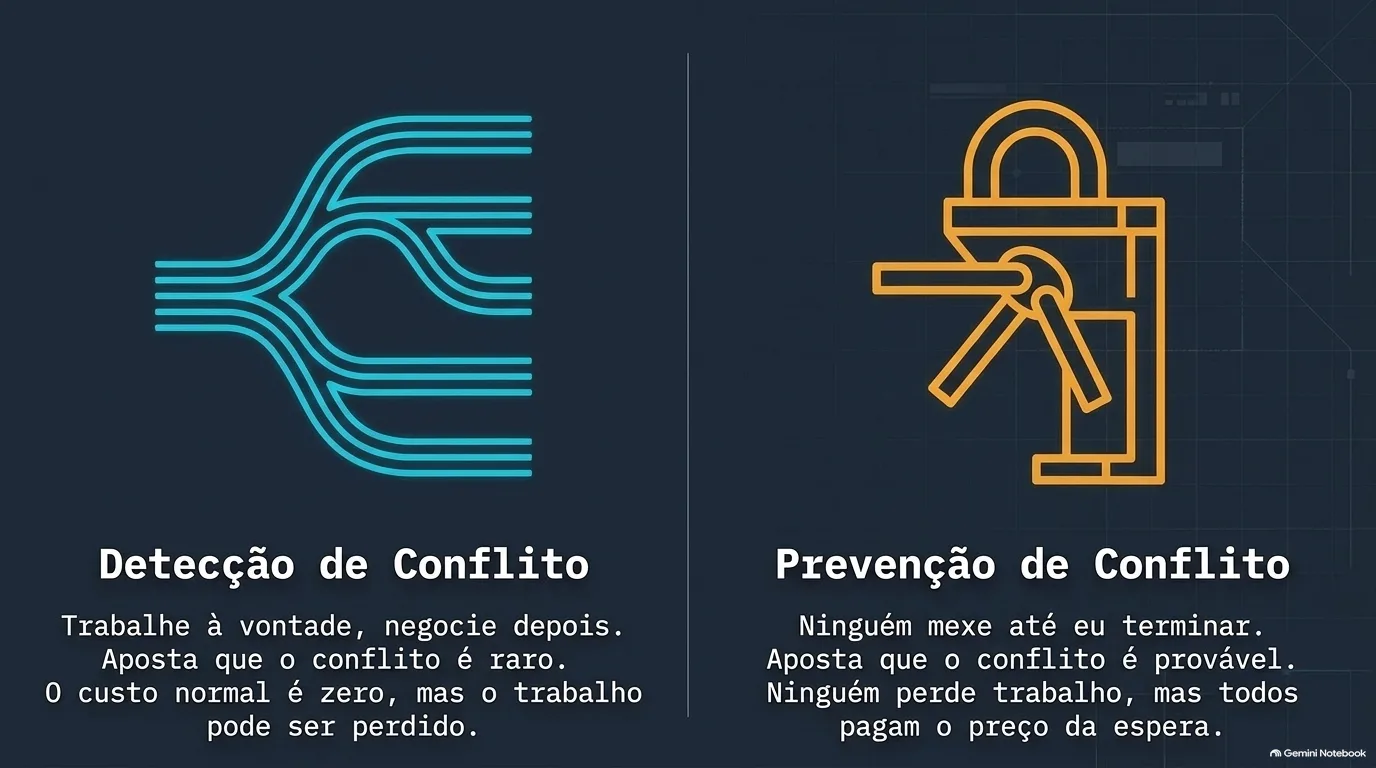
A diferença entre os dois bloqueios cabe numa frase, e é assim que o catálogo de padrões do Martin Fowler os descreve: bloqueio otimista é detecção de conflito; bloqueio pessimista é prevenção de conflito.
Uma boa analogia é o controle de versão, que você usa todo dia. Duas pessoas precisam mexer no mesmo arquivo.
No jeito otimista, o do Git (e antes dele o do CVS e do Subversion), as duas copiam o arquivo e editam à vontade, sem pedir permissão a ninguém. Quem termina primeiro envia sem problema. Quando a segunda tenta enviar, o sistema compara e recusa: isto aqui mudou desde que você copiou. Ela junta as mudanças e envia de novo.
No jeito pessimista, o de sistemas mais antigos no modelo “trava, modifica, destrava”, quem chega primeiro trava o arquivo. A segunda pessoa simplesmente não consegue editar até a primeira liberar. Conflito nunca acontece, porque nunca há duas edições ao mesmo tempo.
A frase carrega três consequências, que valem mais do que ela:
- Onde o custo cai. No otimista, o caso normal é de graça: ninguém espera por ninguém, e só se paga quando o conflito de fato acontece. No pessimista, o custo é cobrado sempre: mesmo quando ninguém mais ia mexer naquela linha, o segundo espera do mesmo jeito. Um cobra por conflito; o outro cobra por acesso.
- Quem lida com a falha. Detecção produz erro, e erro precisa de dono: alguém relê, refaz e tenta outra vez. Prevenção produz espera. Por isso o pessimista parece mais simples no código: no caso normal, não há caminho de exceção para escrever. O preço aparece no comportamento sob carga.
- O que acontece com o trabalho já feito. No otimista, a segunda pessoa trabalhou e pode ter que jogar tudo fora. No pessimista, ela nem começou: ficou parada. Quando o trabalho é caro ou demorado, jogar fora dói; quando é barato, esperar dói mais.
A aposta de cada um está no próprio nome. O otimista aposta que conflito é raro; se estiver certo, você ganha concorrência de graça. O pessimista aposta que conflito é provável; se estiver certo, você evita um monte de trabalho perdido. Escolher entre os dois é uma aposta sobre a frequência de conflito na sua carga, e isso se mede, não se escolhe por gosto.
2. Bloqueio otimista#
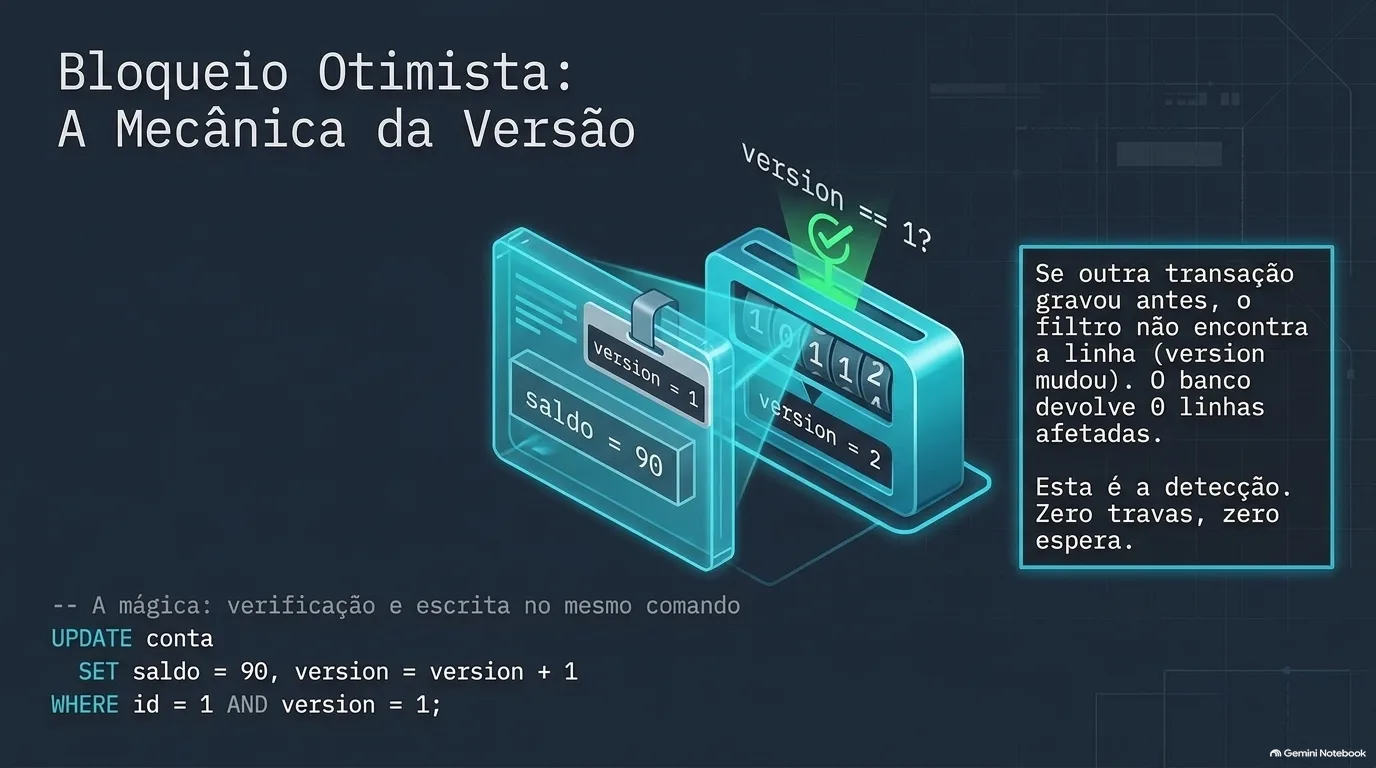
A aposta é que conflito é raro. Ninguém trava nada; todo mundo lê e trabalha à vontade. Na hora de gravar, a escrita carrega a pergunta junto: o dado ainda está como eu li?
A forma de fazer essa pergunta é uma coluna de versão, um número inteiro que muda a cada gravação. Todo UPDATE incrementa a versão e filtra pela versão que foi lida. Se outra transação gravou antes, o filtro não encontra a linha e o banco devolve zero linhas afetadas. Zero linhas afetadas é a detecção do conflito.
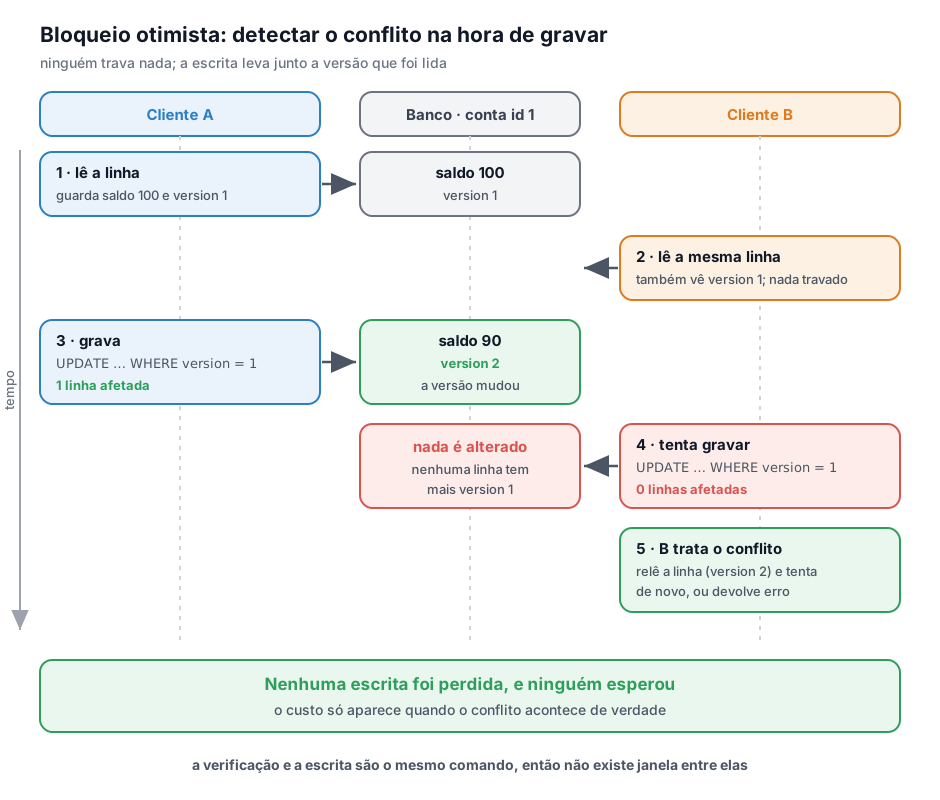
Em SQL puro
-- lido antes: saldo = 100, version = 1UPDATE conta SET saldo = 90, version = version + 1 WHERE id = 1 AND version = 1;-- UPDATE 1 -> gravou-- UPDATE 0 -> alguém mudou a linha nesse meio-tempoO ponto essencial: a verificação e a escrita são o mesmo comando. Não existe janela entre uma e outra, e é por isso que funciona sem travar nada.
Dá para usar uma coluna updated_at no lugar da versão, mas um número inteiro é mais claro e não depende da precisão do relógio. A própria documentação do Hibernate diz que timestamp é uma forma menos confiável de bloqueio otimista do que número de versão.
Em Spring Data JPA
O Hibernate faz isso sozinho a partir de uma anotação:
@Entitypublic class Conta {
    @Id    private Long id;
    private BigDecimal saldo;
    @Version                 // habilita o bloqueio otimista    private Long version;    // o Hibernate cuida do incremento}
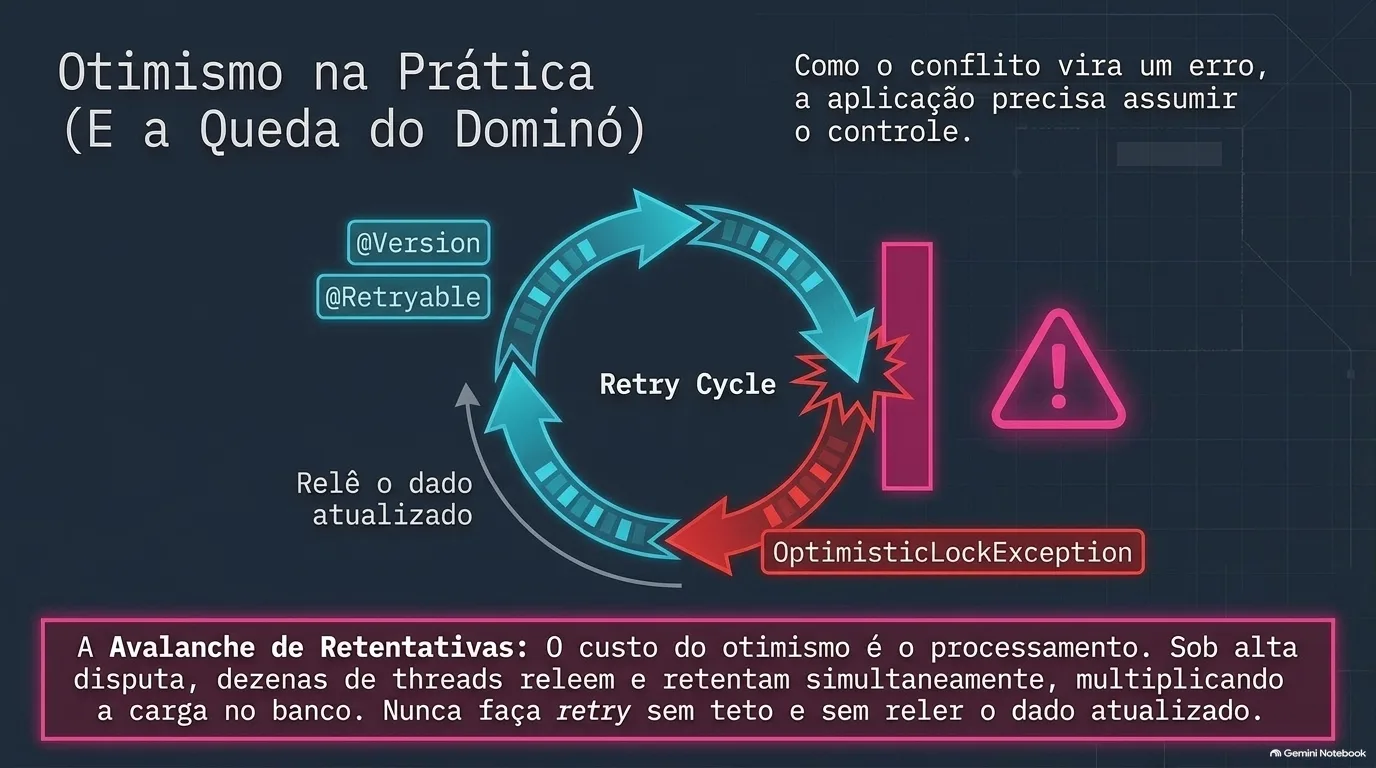
Com isso, todo UPDATE que o Hibernate gera para a entidade inclui a versão no filtro (update conta set saldo=?, version=? where id=? and version=?). Se nenhuma linha for afetada, o Hibernate lança OptimisticLockException (da JPA), e o Spring a entrega traduzida como ObjectOptimisticLockingFailureException.
Como o conflito agora é um erro, alguém precisa decidir o que fazer com ele. Uma resposta comum é tentar de novo. Desde o Spring Framework 7 (Spring Boot 4), a anotação @Retryable faz parte do próprio framework e é habilitada com @EnableResilientMethods numa classe de configuração:
@Retryable( includes = ObjectOptimisticLockingFailureException.class, maxRetries = 2, // 1 tentativa + 2 retentativas delay = 50, multiplier = 2, jitter = 25)@Transactionalpublic void debitar(Long contaId, BigDecimal valor) { Conta conta = repo.findById(contaId).orElseThrow(); conta.setSaldo(conta.getSaldo().subtract(valor)); repo.save(conta);}Dois detalhes que sempre dão errado. Primeiro, o retry precisa reler o dado: retentar com a entidade velha em mãos falha de novo, sempre. Aqui isso funciona porque o @Retryable envolve o @Transactional: cada tentativa abre uma transação nova e faz um findById novo. Segundo, precisa de teto: três tentativas no total, não um laço infinito. Num teste com Spring Boot 4.1, forçando uma gravação concorrente na primeira tentativa, a segunda releu o saldo já alterado e gravou normalmente.
O projeto Spring Retry, de onde vinha o
@RetryablecomretryFore@Backoff, foi arquivado e substituído pelos recursos de resiliência do Spring Framework 7. Em Spring Boot 3, ele ainda é o caminho.
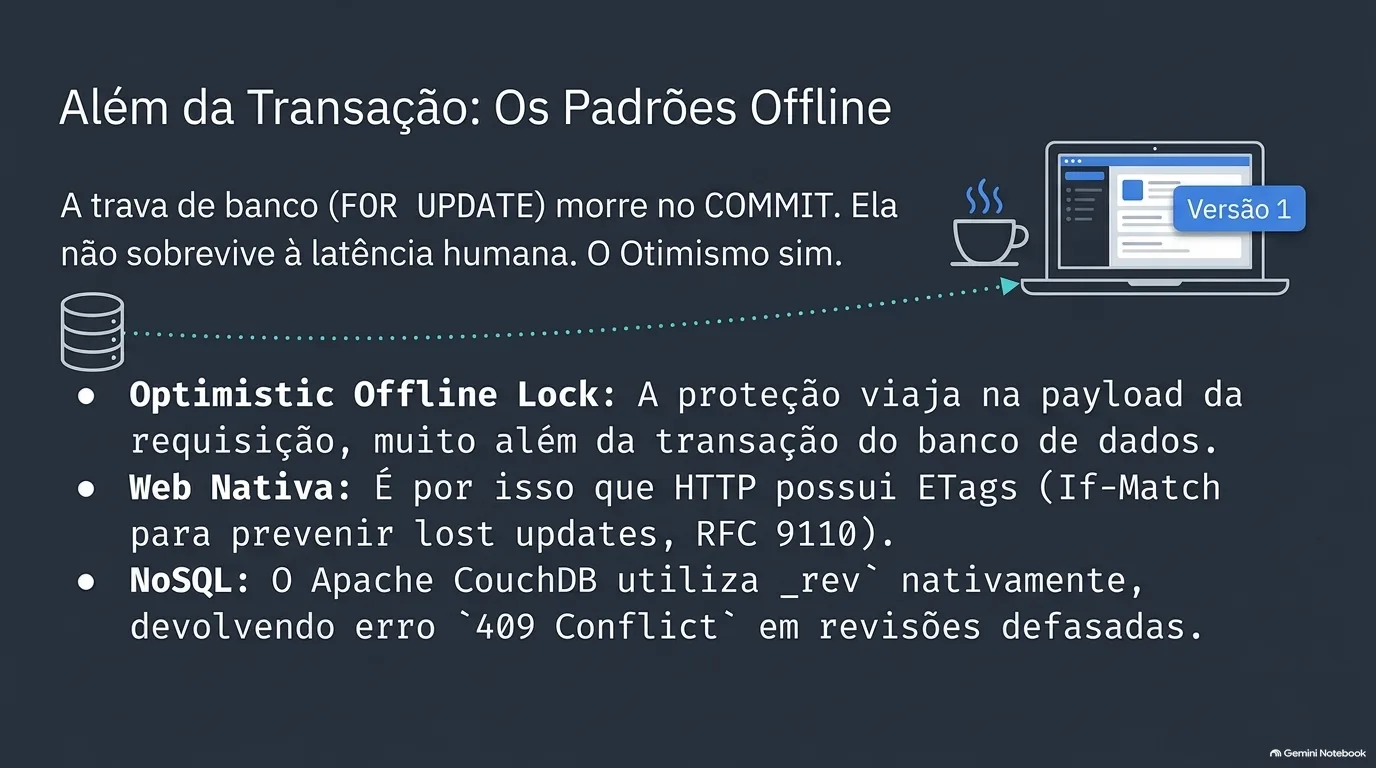
O que costuma passar batido: a versão funciona mesmo entre requisições diferentes, separadas por minutos. Das duas técnicas de banco deste post, é a única que resolve o caso do usuário que abriu um formulário às 10h e salvou às 10h15: a transação no banco durou milissegundos, mas a versão lida às 10h continua sendo o critério. Basta a tela devolver a versão junto com os dados. É exatamente o padrão que o Fowler chama de Optimistic Offline Lock; “offline” porque a proteção atravessa várias requisições, fora de uma única transação do banco.
3. Bloqueio pessimista#
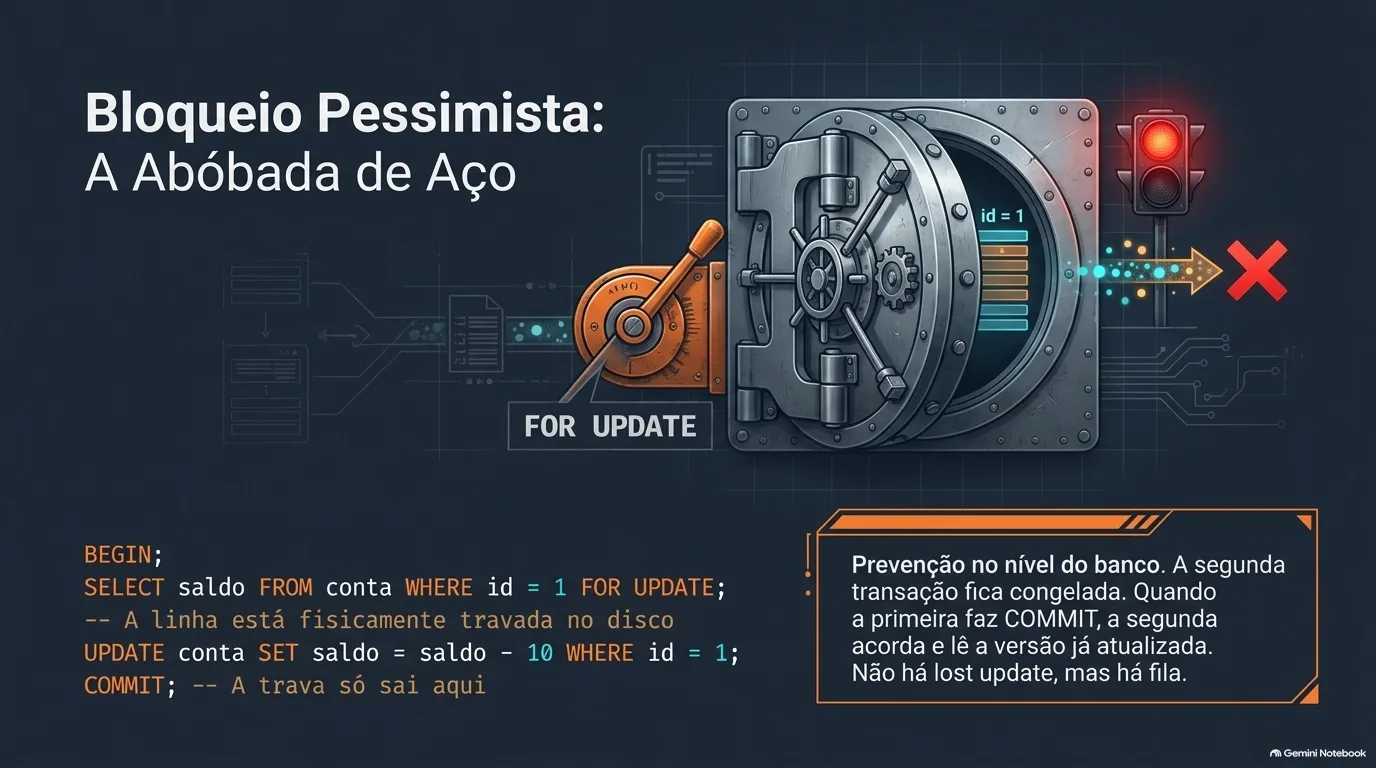
A aposta é a inversa: conflito é provável, então é melhor não deixar acontecer. Quem chega primeiro trava a linha, e os outros esperam.
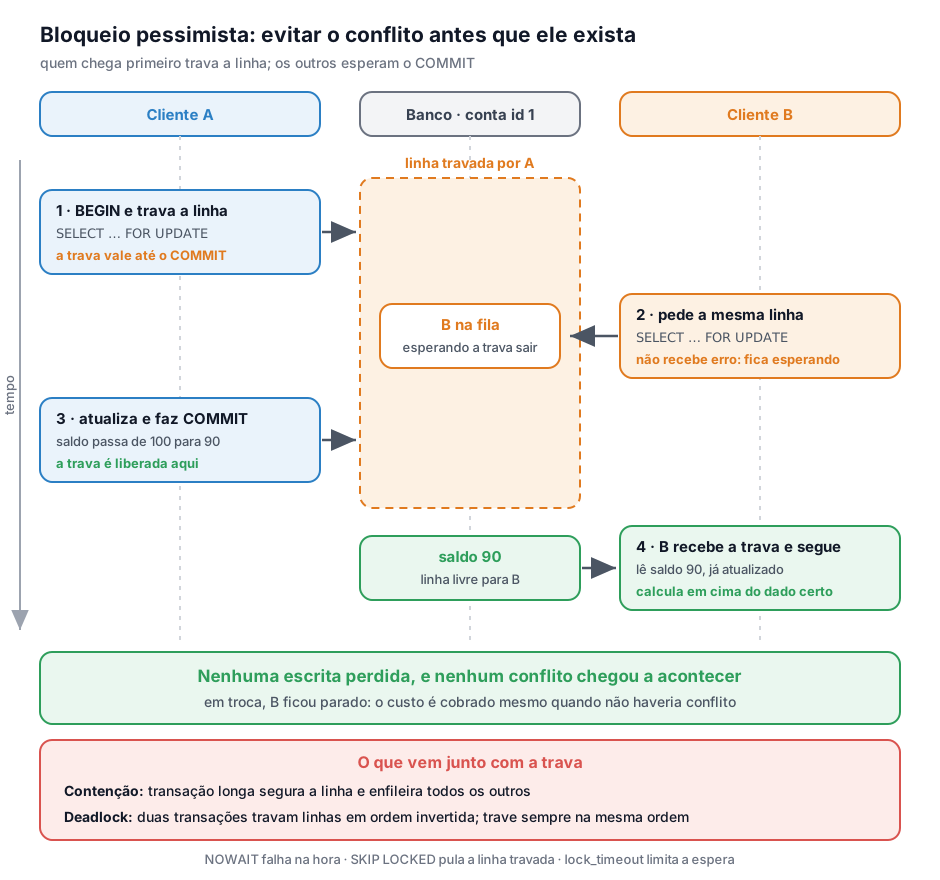
Em SQL puro
BEGIN;
SELECT saldo  FROM conta WHERE id = 1   FOR UPDATE;        -- a partir daqui a linha está travada
-- a aplicação confere o saldo e decide
UPDATE conta SET saldo = saldo - 10 WHERE id = 1;
COMMIT;               -- a trava só sai aqui
Quem pedir a mesma linha com FOR UPDATE nesse meio-tempo fica esperando. Quando a primeira transação faz COMMIT, a segunda recebe a trava e lê a versão já atualizada da linha, e não a que existia quando começou a esperar. É isso que impede o lost update.
Três variações que vale conhecer no PostgreSQL:
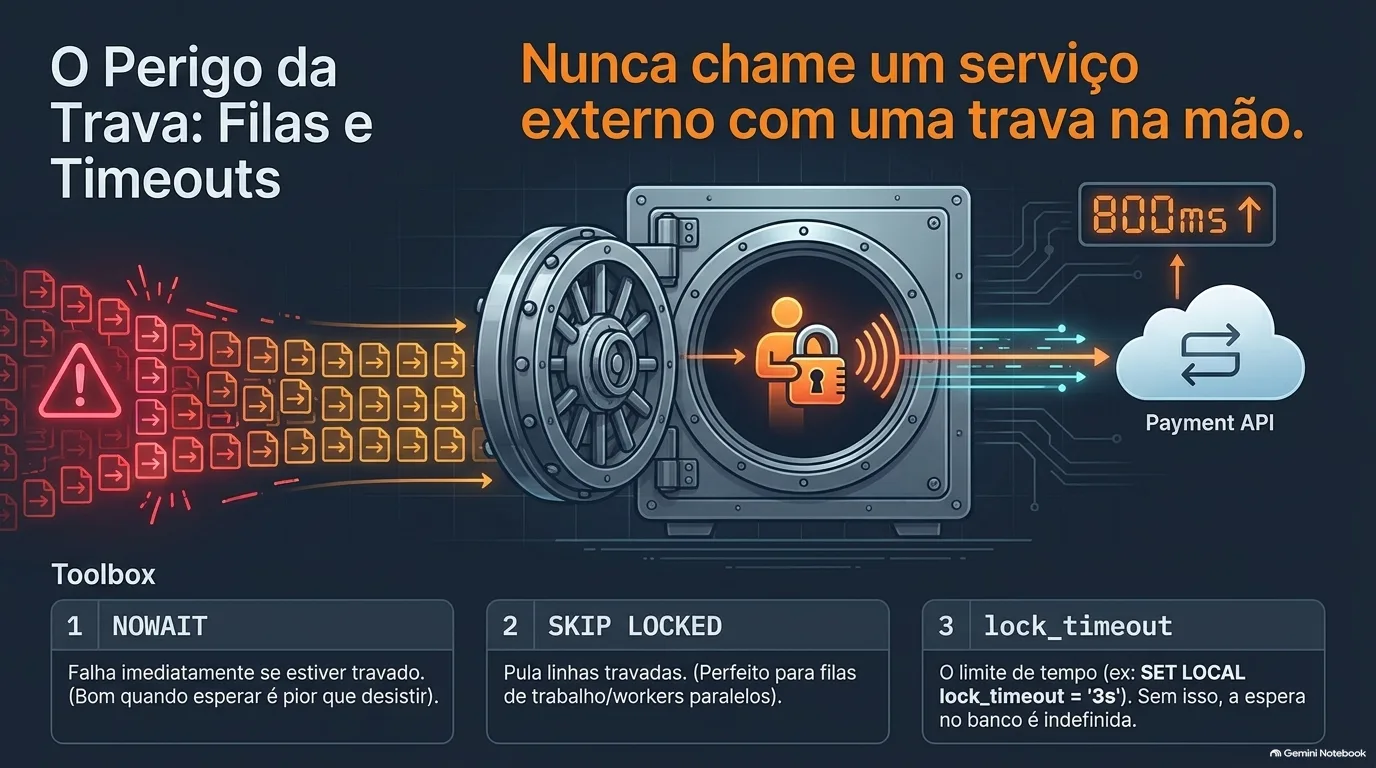
FOR UPDATE NOWAIT: em vez de esperar, falha na hora se a linha estiver travada (could not obtain lock on row). Bom quando esperar é pior que desistir.FOR UPDATE SKIP LOCKED: pula as linhas travadas e devolve as outras. É assim que se implementa fila de trabalho em tabela: vários workers pegam itens diferentes sem disputar o mesmo.lock_timeout: parâmetro de configuração que limita quanto tempo um comando espera por uma trava (por exemplo,SET LOCAL lock_timeout = '3s'vale só para a transação atual). O padrão é0, que desliga o limite: sem configurar, a espera é indefinida.
Em Spring Data JPA
public interface ContaRepository extends JpaRepository<Conta, Long> {
    @Lock(LockModeType.PESSIMISTIC_WRITE)   // no PostgreSQL: SELECT ... FOR NO KEY UPDATE    @QueryHints(@QueryHint(name = "jakarta.persistence.lock.timeout", value = "3000"))    @Query("select c from Conta c where c.id = :id")    Optional<Conta> findByIdParaAtualizar(@Param("id") Long id);}
Três cuidados com esse código:
- O SQL gerado não é exatamente
FOR UPDATE. No PostgreSQL, o Hibernate traduzPESSIMISTIC_WRITEparaFOR NO KEY UPDATE, uma trava um pouco mais fraca: bloqueia UPDATEs, DELETEs e outrosFOR UPDATEouFOR NO KEY UPDATEna linha, mas deixa passar oFOR KEY SHARE, a trava mais leve de todas. Para o lost update, o efeito é o mesmo. - O timeout depende da versão do Hibernate. A dica
jakarta.persistence.lock.timeout(em milissegundos) só funciona no PostgreSQL em versões recentes do Hibernate 7, que executamSET LOCAL lock_timeoutantes da consulta. Em testes contra o PostgreSQL 17, ela funcionou no Hibernate 7.2.24, 7.3.13 e 7.4.5 (os de Spring Boot 4.0.8 e 4.1.1): a espera parou em 3 segundos com erro de trava (no Spring Boot 4.1,CannotAcquireLockException). No Hibernate 6.6 (Spring Boot 3.5) e em 7.1.8, 7.2.0 e 7.3.0, foi ignorada sem aviso, e a espera continuou indefinida. Confirme na sua versão com um teste, ou definalock_timeoutdireto no banco, que vale para qualquer versão. - A trava precisa de uma transação em volta. O método de serviço que chama esse repositório deve ser
@Transactional. Sem transação, a JPA recusa a consulta com trava (TransactionRequiredException, que o Spring entrega comoInvalidDataAccessApiUsageException). E a trava só faz sentido se a leitura e a gravação estiverem na mesma transação, porque ela é liberada no fim dela.
O que costuma passar batido: a trava dura até o commit. Se dentro da transação você chamar o adquirente e ele levar 800 ms, a linha fica travada por 800 ms e todo mundo que quiser aquela linha entra na fila atrás. Não chame serviço externo com uma trava na mão. Como separar a chamada externa da gravação local sem perder nenhuma das duas é o tema do post Efeito externo sem registro local.
4. O UPDATE condicional, que muitas vezes dispensa os dois#
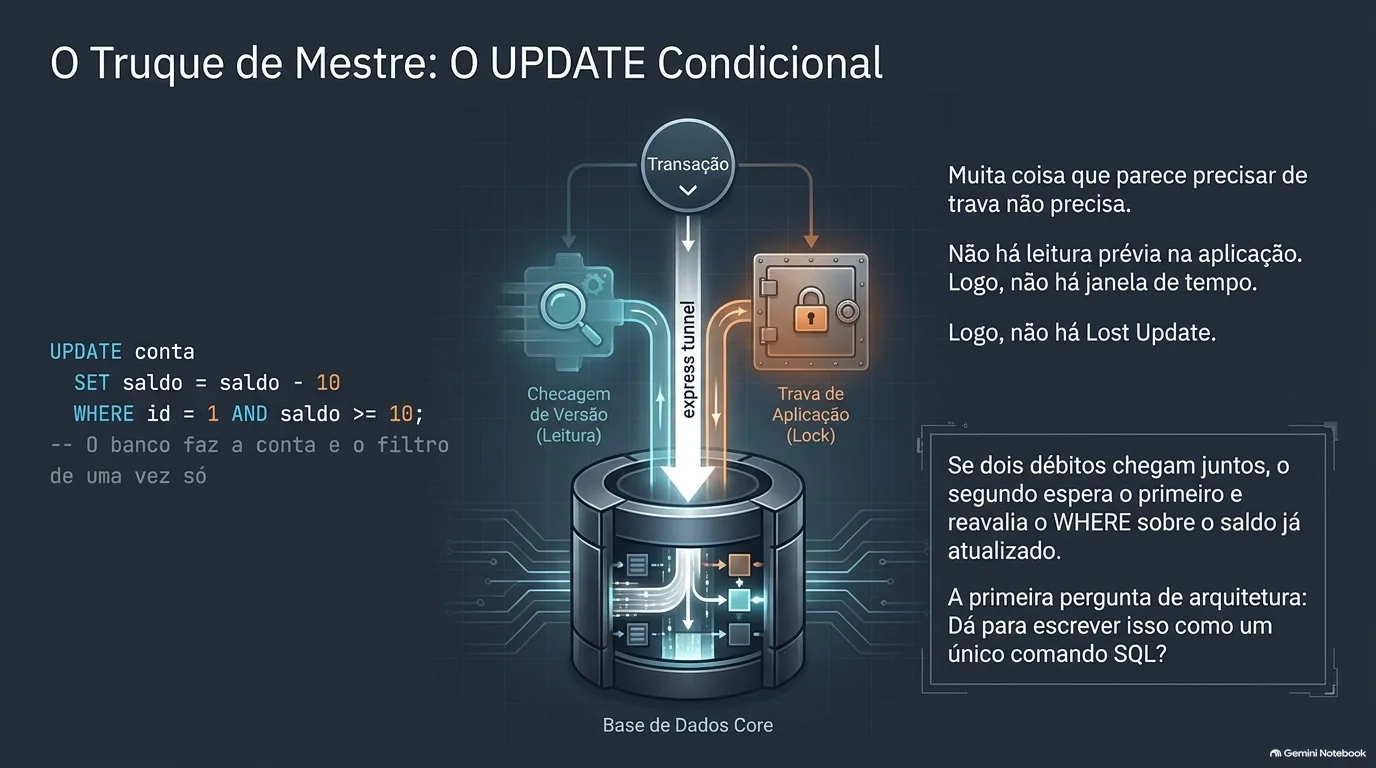
Muita coisa que parece precisar de trava não precisa, porque dá para deixar o próprio banco fazer a conta:
UPDATE conta SET saldo = saldo - 10 WHERE id = 1 AND saldo >= 10;-- UPDATE 1 -> debitou-- UPDATE 0 -> saldo insuficienteAqui não há leitura prévia na aplicação, então não há janela e não há lost update. O UPDATE trava a linha por conta própria enquanto grava. Se dois débitos chegam juntos, o segundo espera o primeiro terminar e, no nível de isolamento padrão do PostgreSQL, reavalia o WHERE sobre o saldo já atualizado. Num teste com saldo 15 e dois débitos simultâneos de 10, um afetou uma linha e o outro afetou zero, e o saldo terminou em 5.
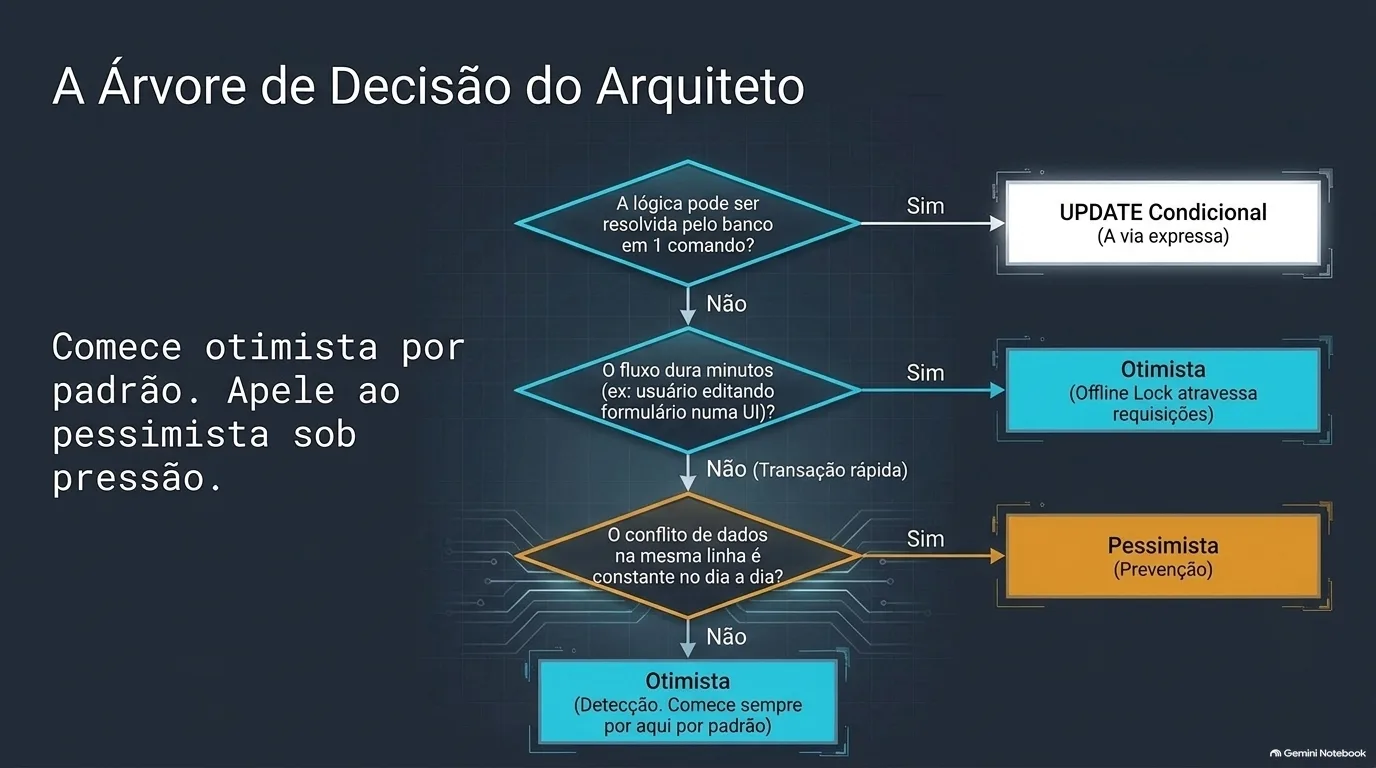
Essa é a primeira pergunta a fazer antes de escolher entre otimista e pessimista: dá para escrever isso como um único comando? Se der, nenhum dos dois é necessário. No post sobre arquitetura de ledger, a mesma ideia aparece como balance locking: condicionar a escrita ao saldo em vez de à versão.
5. Como escolher#
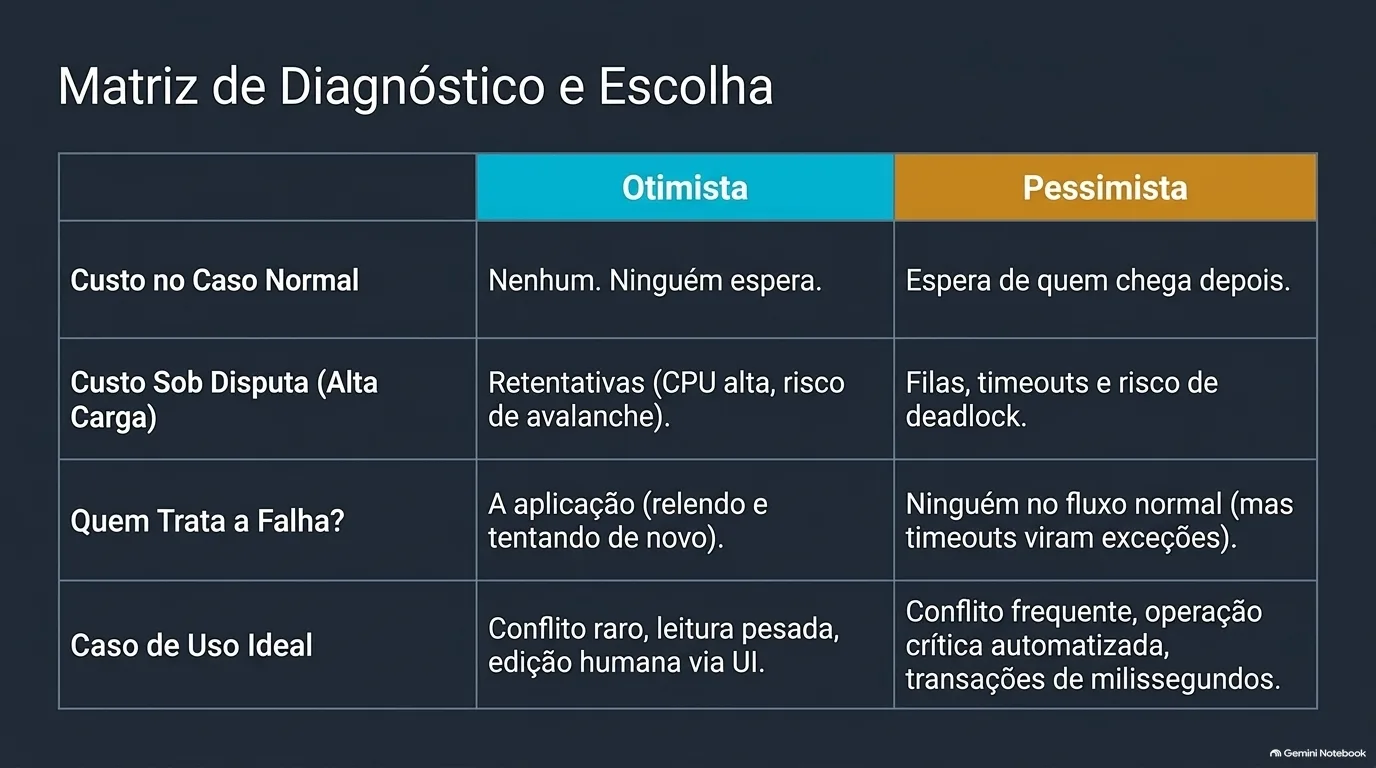
| Otimista | Pessimista | |
|---|---|---|
| Estratégia | detecta o conflito ao gravar | evita o conflito antes |
| Custo no caso normal | nenhum: ninguém espera | espera de quem chega depois |
| Custo sob disputa | retentativas, que podem virar avalanche | fila, e risco de deadlock |
| Quem trata a falha | a aplicação, relendo e tentando de novo | ninguém no caso normal; timeout e deadlock ainda viram erro |
| Funciona entre requisições? | sim, com a versão indo e voltando | não com trava de banco, que só vive dentro da transação |
| Onde encaixa | conflito raro, leitura pesada, edição por tela | conflito frequente, operação crítica, transação curta |
Na descrição do Fowler, o pessimista limita a concorrência do sistema, enquanto o otimista deixa várias pessoas trabalharem nos mesmos dados ao mesmo tempo. Na prática, isso leva a uma regra que funciona bem: comece otimista, que é mais simples e não cria filas. A pergunta certa não é “quando usar o otimista”, e sim “quando o otimista sozinho não basta”.
No meu domínio, o critério prático é a taxa de disputa pela mesma linha. Cadastro de cooperado, limite, parâmetro de produto: otimista. Saldo de uma única conta em dia de pico, ou contador de uso de limite: pessimista ou, melhor ainda, um único UPDATE condicional.
6. Padrões nomeados#
Já explicados acima; aqui fica só o nome formal
- Lost update: duas leituras, dois cálculos, duas escritas, e uma delas desaparece sem erro. Onde mais aparece: contador de estoque, saldo, qualquer campo calculado a partir do valor lido.
- Optimistic Offline Lock: nome do padrão no catálogo do Fowler. “Offline” porque a proteção vale além de uma transação do banco, atravessando requisições. Onde mais aparece:
ETagcomIf-Matchem HTTP, que a RFC 9110 descreve justamente como proteção contra o lost update; o campo_revno CouchDB, que recusa com 409 a gravação feita sobre uma revisão antiga; edição concorrente de documentos. - Pessimistic Offline Lock: o par do anterior. Como a trava de banco não sobrevive ao fim da transação, aqui a trava é da aplicação: um registro (numa tabela de travas, por exemplo) dizendo quem está editando o quê, obtido antes de começar e liberado no fim. Onde mais aparece: check-out de arquivo em sistemas de versão antigos, reserva de assento, qualquer “só um por vez”.
Mencionados de passagem; vale saber o que são
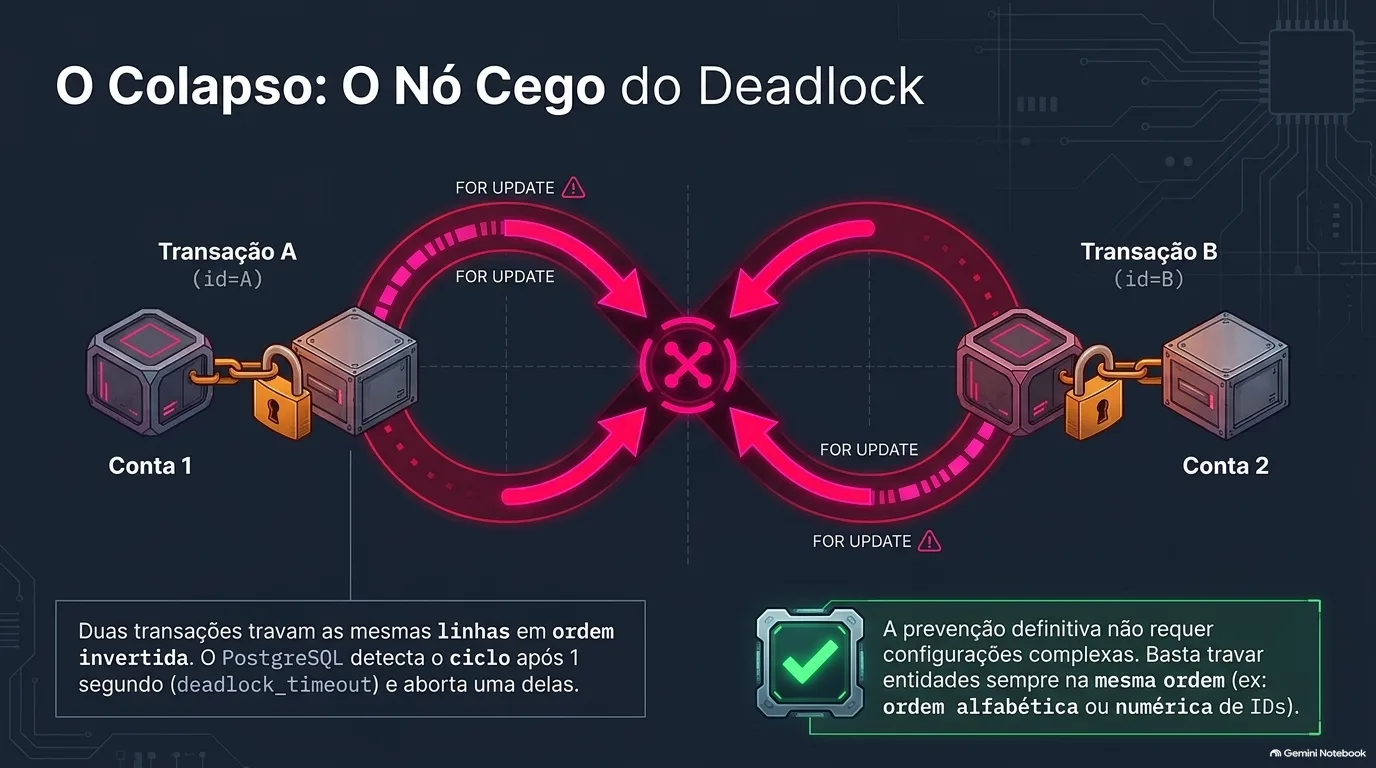
- Deadlock: duas transações travam as mesmas linhas em ordem invertida e ficam esperando uma pela outra para sempre. O PostgreSQL detecta o ciclo (a checagem roda depois de
deadlock_timeout, 1 segundo por padrão) e aborta uma das duas comdeadlock detected. A prevenção é simples e quase nunca feita: travar sempre na mesma ordem, por exemplo ordenando por id. É um risco típico do pessimista, mas não exclusivo dele: um UPDATE comum também trava a linha até o commit, então duas transações que atualizam as mesmas contas em ordem invertida podem entrar em deadlock mesmo semFOR UPDATE, com ou sem coluna de versão. - Níveis de isolamento: a outra forma de tratar concorrência, no nível da transação inteira em vez de linha a linha. O PostgreSQL usa READ COMMITTED por padrão, que não impede o lost update do padrão “leu na aplicação, calculou, gravou”; daí a necessidade de bloqueio explícito. Em REPEATABLE READ e SERIALIZABLE, o PostgreSQL impede, mas abortando a segunda transação com
could not serialize access due to concurrent update, e a aplicação precisa saber retentar. Vale saber que existe: é pergunta clássica de entrevista para vaga sênior. SELECT ... FOR UPDATE SKIP LOCKEDcomo fila: truque para usar uma tabela como fila de trabalho sem broker de mensagens. A documentação do PostgreSQL cita exatamente esse uso: evitar disputa entre vários consumidores de uma tabela que funciona como fila. Por que importa: permite processar lotes com vários workers em paralelo sem que dois peguem o mesmo item.
7. Onde eu apertaria numa entrevista#
- Você colocou
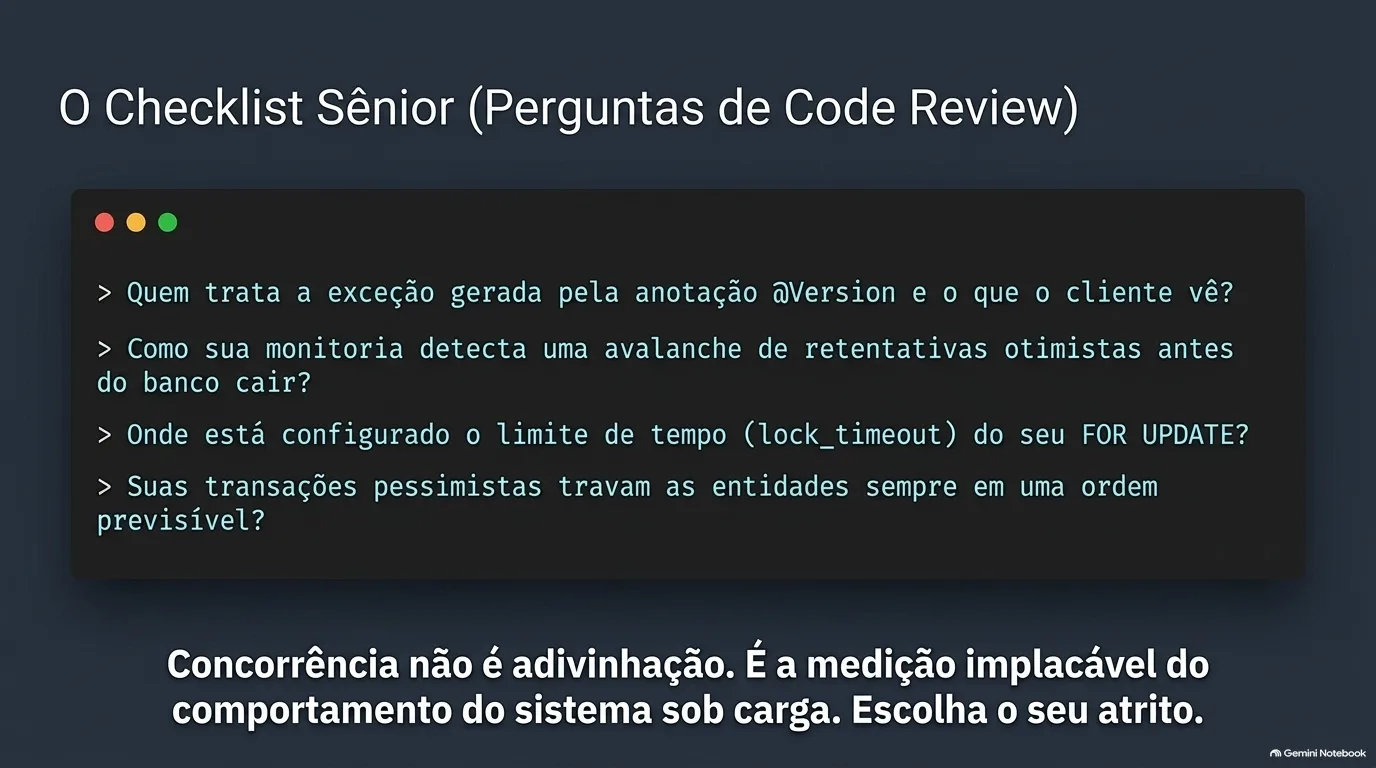
@Versione o conflito virou exceção. Quem trata? E o que o usuário final vê? - Sob disputa alta, o otimista entra em avalanche de retentativas. Como você percebe isso antes do cliente?
- Uma transação com
FOR UPDATEchama o adquirente por dentro. O que acontece com as outras requisições daquela conta? - Como você evita deadlock quando precisa travar duas linhas na mesma transação?
- O time quer subir o isolamento para SERIALIZABLE e “resolver de uma vez”. Que argumento você traz?
8. Apresentação
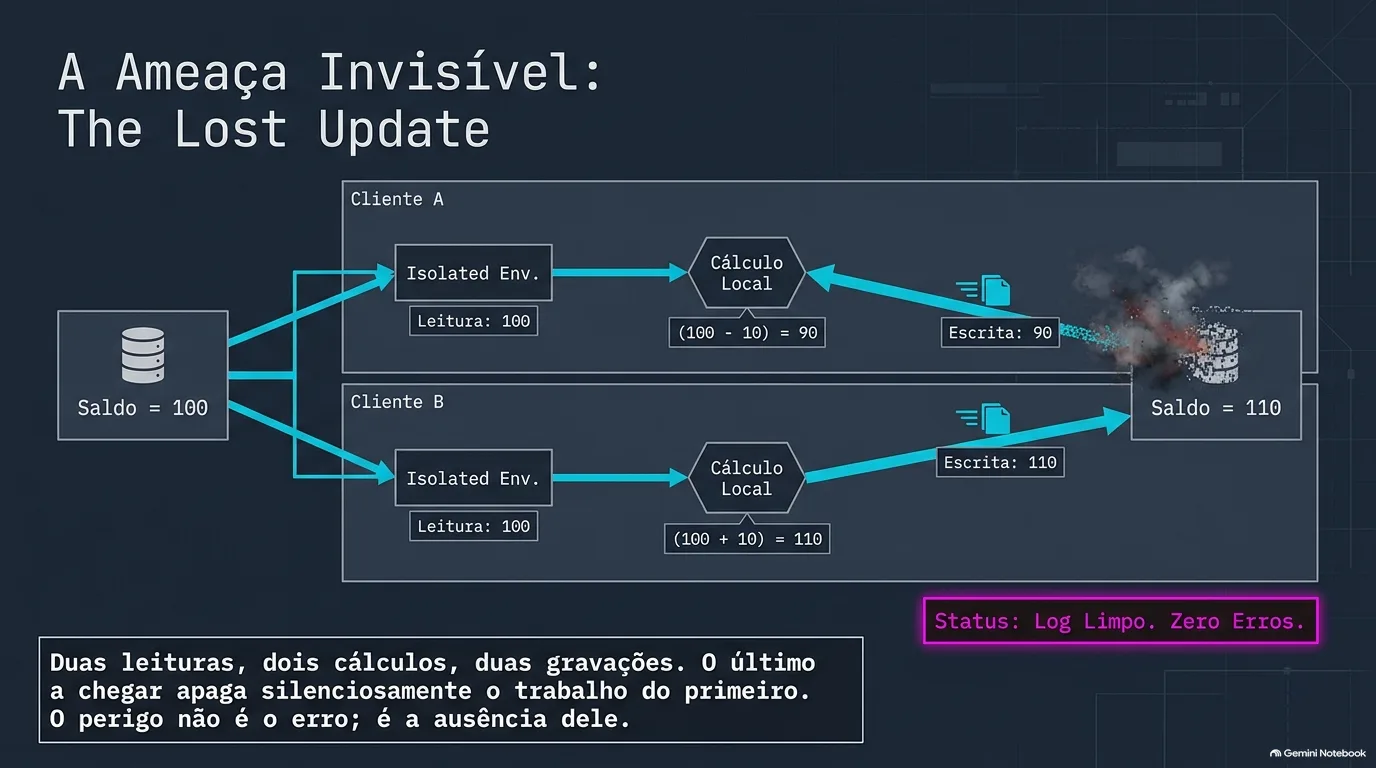
Apresentação gerada no NotebookLM a partir deste artigo. Como são imagens, podem conter erros de texto — a referência é o artigo acima.
Fontes#
- Martin Fowler — Optimistic Offline Lock (Patterns of Enterprise Application Architecture)
- Martin Fowler — Pessimistic Offline Lock
- Version Control with Subversion — Version Control Basics (lock-modify-unlock e copy-modify-merge)
- PostgreSQL — Explicit Locking (modos de trava de linha e deadlocks)
- PostgreSQL — SELECT: cláusula de trava (NOWAIT, SKIP LOCKED)
- PostgreSQL — Client Connection Defaults (
lock_timeout) - PostgreSQL — Transaction Isolation
- Hibernate ORM — User Guide: Locking
- Hibernate ORM —
PostgreSQLLockingSupport(aplicação do lock timeout viaSET LOCAL lock_timeout) - Spring Data JPA — Locking e Transactionality
- Spring Framework — Resilience Features (
@Retryable) - Spring Retry — repositório (arquivado, substituído pelo Spring Framework 7)
- IETF — RFC 9110, HTTP Semantics (requisições condicionais e o “lost update”)
- Apache CouchDB — API de documentos (
_reve 409 Conflict) - Vlad Mihalcea — artigos sobre explicit locking em JPA e Hibernate
- Stormatics — Ensuring Safe Data Modifications in PostgreSQL, parte 2 (bloqueio otimista)