 Cesar Schutz
Seu serviço cobrou o cliente no adquirente (a empresa que processa a transação de cartão), mas o processo morreu antes de gravar a cobrança no banco. O dinheiro saiu e você não tem registro disso. Este post mostra por que retry e alerta não resolvem, e qual desenho garante que todo efeito externo deixa rastro local: gravar a intenção antes de agir, com tabela outbox, relay e conciliação. É a continuação de Cobrança duplicada no retry.
Formato do artigo: um cenário real, a primeira resposta que costuma aparecer, onde ela falha e o que fica de aprendizado.
1. Desafio#
A chave de idempotência está implantada e funcionando. Um dia, o gráfico mostra cobranças que aparecem na fatura do cliente, mas não existem no seu banco.
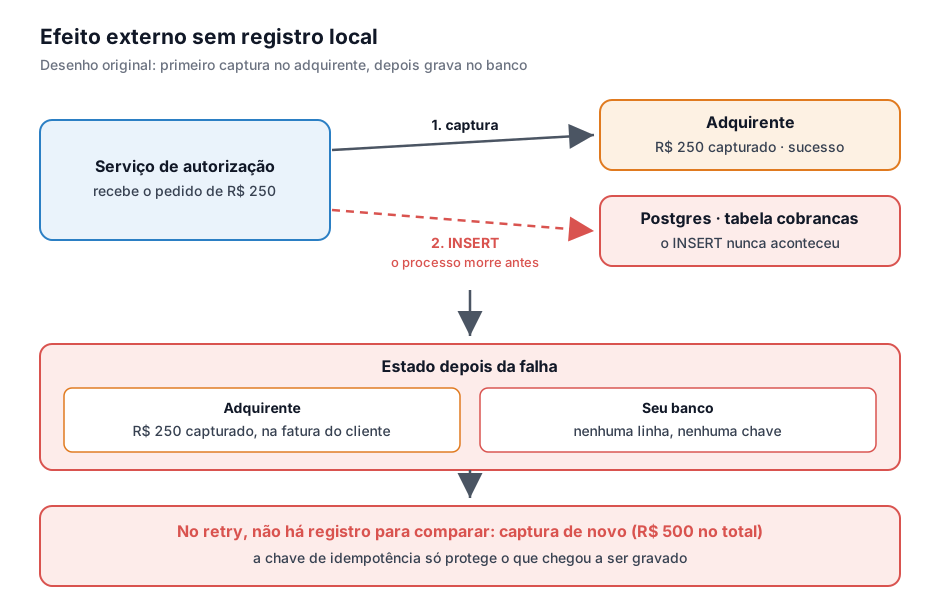
Investigando, o fluxo é este: o serviço chama o adquirente, a captura (a efetivação da cobrança) passa, e só depois o serviço grava a cobrança no Postgres. Entre as duas coisas, o processo morreu.
Como você desenha isso para que nunca exista dinheiro cobrado sem registro?
O que o cenário não diz, e vale perguntar: com que frequência isso acontece, se o adquirente permite consultar o status depois e quanto tempo o cliente aceita esperar pela resposta.
2. A primeira resposta#
Envolvo a chamada em try/catch. Se a gravação falhar, faço retry algumas vezes; se ainda assim falhar, registro no log e disparo um alerta para o time olhar.
3. Onde furou#
Retry e alerta tratam o sintoma depois que o dano já existe. Nenhum dos dois muda o fato estrutural: o efeito externo aconteceu antes de existir qualquer registro local.
E se o processo morre de verdade, não há try/catch que rode: o bloco de tratamento morre junto. Isso acontece quando o contêiner é encerrado à força (SIGKILL), seja por falta de memória (OOM), seja num deploy que estoura o prazo de desligamento. O post SIGTERM e SIGKILL detalha esse ciclo no Kubernetes.
O detalhe mais desconfortável: a chave de idempotência do post sobre cobrança duplicada no retry não protege aqui. Ela só existiria dentro da linha que não chegou a ser gravada, então o retry seguinte chega sem nada para comparar e captura de novo.
4. Aprendizado: o problema da escrita dupla#
Escrever em dois sistemas que não compartilham transação é a escrita dupla (dual write). Seu banco não sabe nada sobre o adquirente, e não existe commit que cubra os dois. Uma falha entre as duas escritas deixa os dois lados discordando.
O que não resolve, mesmo parecendo que resolve:
- Inverter a ordem: gravar a cobrança como concluída e só depois chamar o adquirente troca o problema de lado. Em vez de cobrança sem registro, você passa a ter registro sem cobrança.
- Retry no catch: só roda se o processo continuar vivo. E, quando a falha é ambígua (um timeout, por exemplo), ela não diz se a operação aconteceu; repetir às cegas pode transformar perda em duplicidade.
- Transação distribuída com 2PC (two-phase commit, explicado na seção 5): a API do adquirente não participa desse protocolo. E, mesmo entre sistemas que participam, os recursos ficam travados enquanto o coordenador não decide, e uma falha do coordenador deixa todos bloqueados.
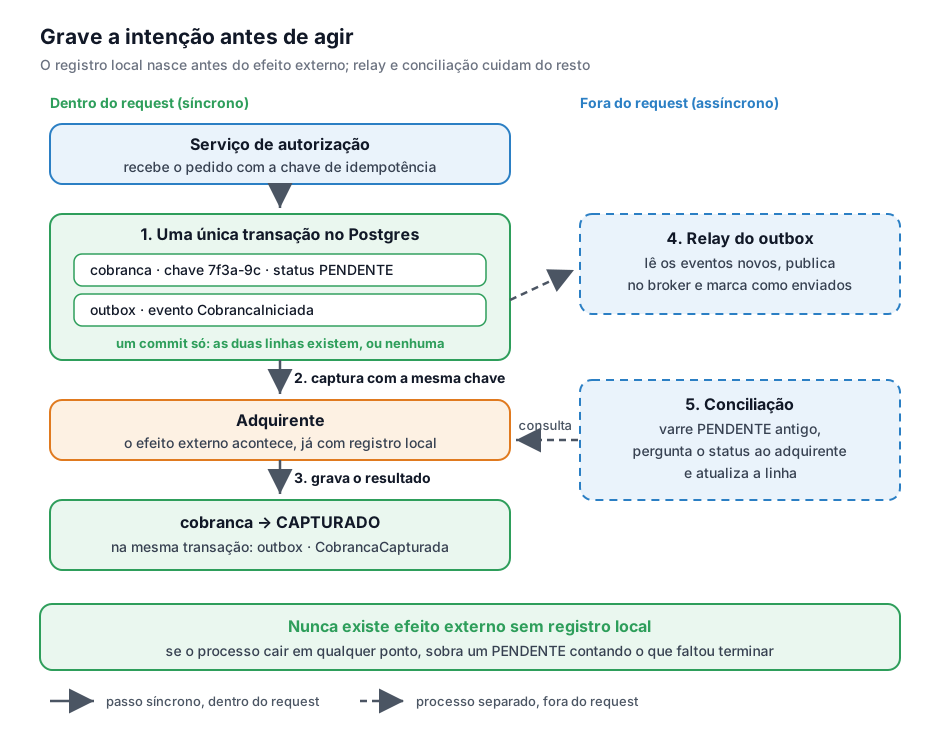
O que resolve é mudar o que se escreve primeiro: grave a intenção antes de causar o efeito.
- Numa única transação do Postgres, o serviço grava a cobrança com status PENDENTE e, na tabela outbox (uma tabela de eventos a publicar), o evento
CobrancaIniciada. Ou as duas linhas existem, ou nenhuma. - Só depois do commit ele chama o adquirente, enviando a mesma chave de idempotência, se o adquirente aceitar uma (a API da Stripe, por exemplo, aceita o cabeçalho
Idempotency-Key). Assim, repetir a captura é seguro. - Com a resposta, atualiza a linha para CAPTURADO e grava o evento
CobrancaCapturadano outbox, também numa transação só.
Se o processo cair no meio do caminho, sobra um PENDENTE contando exatamente o que faltou terminar. E o retry do cliente agora esbarra numa linha que existe: em vez de capturar às cegas, o serviço sabe que precisa descobrir o que aconteceu com aquela chave.
Duas peças completam o desenho:
- Relay do outbox: um processo separado lê a tabela outbox, publica os eventos no broker de mensagens e os marca como enviados. Se cair no meio, publica de novo, então a entrega é pelo menos uma vez e quem consome precisa ser idempotente.
- Conciliação: um job varre os PENDENTE antigos e pergunta o status ao adquirente. Se a captura passou, atualiza a linha; se não passou, marca como falha ou tenta de novo com a mesma chave. É a rede que pega o que escapou.
5. Padrões nomeados#
Já explicados acima; aqui fica só o nome formal
- Dual write problem: uma operação lógica que precisa escrever em dois sistemas sem transação comum; qualquer falha no meio deixa os dois discordando. Onde mais aparece: banco mais fila, banco mais cache, banco mais índice de busca, banco mais API de terceiro. É a mesma forma em todos.
- Transactional outbox: dado e evento gravados na mesma transação; a entrega do evento vira um passo separado e repetível. Onde mais aparece: qualquer serviço que precisa avisar outro depois de mudar o próprio estado, como no post sobre W3C Trace Context, em que o
traceparentviaja pelo outbox. - Intenção gravada antes do efeito (pending state): registrar a intenção antes de causar o efeito, para que a falha deixe rastro em vez de silêncio. É um nome descritivo, não um padrão de catálogo; o artigo de Brandur Leach sobre chaves de idempotência formaliza a mesma ideia como fases atômicas com pontos de recuperação. Onde mais aparece: upload em duas etapas, emissão de nota fiscal, provisionamento de recurso em nuvem. É o princípio do write-ahead log do banco (a mudança é registrada no log antes de ser aplicada) levado para o nível da aplicação.
- Reconciliation (conciliação): comparar periodicamente o seu estado com o do sistema externo e corrigir a diferença. Onde mais aparece: fechamento contábil, estoque integrado a marketplace, cobrança recorrente. O post Arquitetura de ledger mostra a conciliação aplicada a saldos.
Mencionados de passagem; vale saber o que são
- Change Data Capture (CDC): em vez de um processo consultar a tabela outbox de tempos em tempos (polling), uma ferramenta lê o log de transações do próprio banco e publica cada mudança quase em tempo real. O Debezium é o nome mais comum. Quando usar no lugar do relay por polling: quando o atraso do intervalo de consulta não cabe, ou quando o volume torna as consultas caras. O que custa: mais uma peça de infraestrutura para operar e monitorar. Por isso o polling, que funciona com qualquer banco SQL, costuma ser o ponto de partida.
- Event sourcing: em vez de guardar o estado atual e emitir eventos, você guarda só a sequência de eventos e calcula o estado a partir dela. Resolve a escrita dupla entre estado e eventos por eliminação: gravar um evento é uma operação só. Atenção: não elimina a chamada ao adquirente; o efeito externo continua precisando da intenção registrada antes. Quando aparece: quando o histórico completo é requisito de negócio, o que é comum em domínio financeiro. O que custa: muda o modelo de dados inteiro e dificulta consultas (em geral exige CQRS), então é decisão de arquitetura, não ajuste pontual.
- Two-phase commit (2PC): protocolo em que um coordenador pergunta a todos os participantes se podem confirmar e só então manda confirmar. Existe e funciona entre recursos que o suportam, mas é bloqueante: os participantes seguram travas enquanto esperam a decisão e, se o coordenador falha, ficam presos. E uma API HTTP de terceiro, como a do adquirente, não é participante de 2PC. Por que está aqui: é a resposta que parece óbvia para quem acabou de conhecer o problema, e saber por que ela é rejeitada vale mais do que saber que ela existe.
6. Onde eu apertaria numa entrevista#
- O relay parou silenciosamente. Como você descobre antes do cliente?
- Quanto tempo uma cobrança pode ficar PENDENTE antes de virar incidente?
- E se o adquirente responder “não sei” quando a conciliação perguntar?
- A tabela outbox cresce sem parar. Quem limpa, e quando?
- Se a conciliação roda como CronJob no Kubernetes, o que acontece quando duas execuções se sobrepõem?
- Vale trocar o relay por CDC no seu caso, ou o polling já resolve?
Fontes#
- AWS Prescriptive Guidance — Transactional outbox pattern
- Confluent — Understanding the Dual-Write Problem
- microservices.io — Pattern: Transactional outbox
- microservices.io — Pattern: Polling publisher
- microservices.io — Pattern: Event sourcing
- Debezium — Reliable Microservices Data Exchange With the Outbox Pattern
- Brandur Leach — Implementing Stripe-like Idempotency Keys in Postgres
- Stripe — Idempotent requests
- PostgreSQL — Write-Ahead Logging (WAL)
- PostgreSQL — PREPARE TRANSACTION
- Wikipedia — Two-phase commit protocol
- Kubernetes — Assign Memory Resources to Containers
- Kubernetes — Pod Lifecycle: Termination of Pods