 Cesar Schutz
Em discussões de arquitetura, “isso tem muito overhead” e “isso é overkill” costumam ser usados como sinônimos. Não são, e confundir os dois leva a decisões ruins nos dois sentidos: rejeitar algo necessário porque “tem overhead” ou adotar algo exagerado porque “o overhead de runtime é baixo”.
- Overhead é o custo extra (operacional ou de esforço) que uma escolha cobra além do trabalho essencial. É o “imposto” da escolha.
- Overkill (ou overengineering) é aplicar uma solução complexa ou desproporcional a um problema simples. É o “exagero” da escolha.
A diferença de fundo: overhead é descritivo (toda escolha tem algum), enquanto overkill é um juízo de valor sobre a proporção entre a complexidade da solução e o tamanho real do problema. Bom design não elimina overhead: aceita o overhead certo pelos motivos certos. Overkill é quando essa proporção quebra.
Neste post você vai ver as seis dimensões em que o overhead aparece (e por que olhar só CPU e memória engana), exemplos de overhead que compensa e de overkill clássico, e um critério prático para decidir.
1. Overhead — o “imposto” inevitável de toda escolha#
Overhead é o custo que uma decisão técnica cobra além do trabalho essencial. Adicionar um cache, por exemplo, reduz a latência, mas cobra memória extra, regras de invalidação, um componente a mais para monitorar e uma classe nova de bugs (dado desatualizado). Toda escolha tem overhead: o objetivo não é zerá-lo, é decidir conscientemente onde gastá-lo.
2. As seis dimensões do overhead#
O erro clássico é avaliar overhead só pelo runtime (CPU, memória, latência). Hardware costuma ser barato perto do custo de gente; o que sai caro é o que não aparece no dashboard de APM (Application Performance Monitoring, ferramentas que medem latência, erros e consumo de recursos da aplicação).
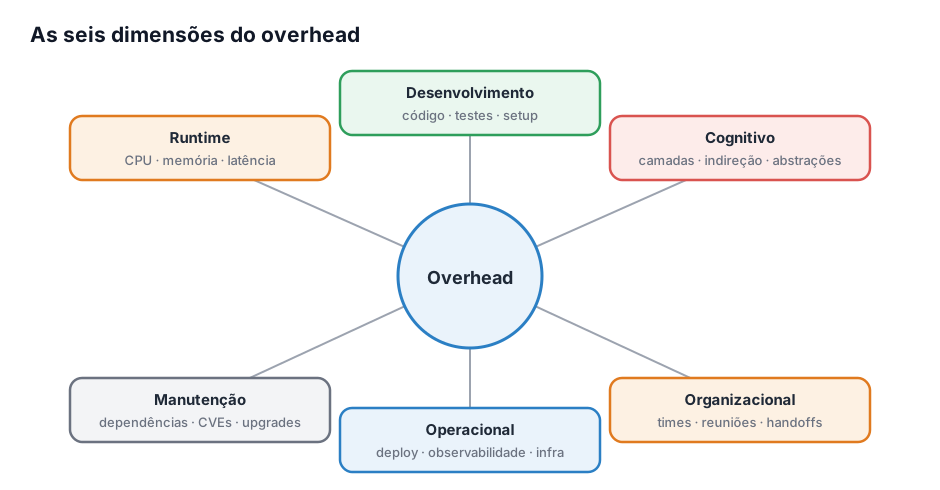
O diagrama resume as seis dimensões. Só a primeira aparece com facilidade em métricas; as outras cinco se manifestam em prazo, em bugs e em pessoas.
a) Runtime (o mais óbvio)
- CPU, memória, latência, I/O, rede, armazenamento.
- Fácil de medir e de justificar tecnicamente.
b) Desenvolvimento
- Mais código para escrever, mais testes para cobrir, mais configuração para manter.
- Curva de aprendizado da stack escolhida.
- Setup do ambiente local: um dev novo roda o projeto em 2 dias ou em 2 semanas?
- Tempo gasto em decisões de design que poderiam ser triviais.
c) Cognitivo (frequentemente o pior)
- Quantos conceitos alguém precisa ter em mente para entender um fluxo simples?
- Indireção excessiva: para entender o que um endpoint faz, é preciso navegar por 7 camadas, 3 interfaces e 2 design patterns.
- Abstrações prematuras, que escondem mais do que revelam. Sandi Metz resume bem: duplicação sai muito mais barata que a abstração errada.
- É o tipo de custo que faz uma pessoa sênior levar uma tarde numa mudança que deveria levar 15 minutos.
d) Manutenção
- Mais dependências = mais CVEs (vulnerabilidades de segurança catalogadas publicamente), mais upgrades, mais incompatibilidades.
- Mais serviços = mais pipelines, mais dashboards, mais alertas, mais plantão (on-call).
- Documentação que precisa ficar sincronizada com o código.
- Refatoração: mudar algo simples exige tocar em N lugares.
e) Operacional
- Observabilidade: tracing distribuído e correlação de logs entre serviços (veja W3C Trace Context e Wide Events).
- Depurar problemas que atravessam fronteiras de rede ou de processo.
- Deploy coordenado, versionamento de contratos, compatibilidade entre serviços.
- Custo de infraestrutura: cluster, brokers de mensageria, bancos extras, ferramentas de APM.
f) Organizacional
- Mais times, mais reuniões de alinhamento, mais passagens de trabalho entre times (handoffs).
- Onboarding mais lento.
- Conhecimento concentrado em poucas pessoas (“só o fulano sabe mexer nisso”).
3. Overhead que costuma compensar (e quando deixa de compensar)#
Ter overhead não é problema. A pergunta é se o que se ganha paga o que se gasta:
- HTTPS — cobra handshake TLS e criptografia. Compensa quase sempre: quando o Gmail passou a usar HTTPS por padrão em 2010, o Google relatou que SSL/TLS respondia por menos de 1% da CPU dos servidores de frontend, sem máquinas adicionais.
- Garbage collector — cobra pausas e CPU. É o preço de não gerenciar memória manualmente; para muitas aplicações é irrelevante, mas em sistemas com muitos gigabytes de heap, muitas threads e alto volume de transações a escolha e o ajuste do coletor passam a importar.
- ORM — cobra uma camada de abstração e, às vezes, queries subótimas. Costuma compensar em sistemas com muito CRUD, porque elimina boa parte do código repetitivo de mapeamento; nas queries críticas, dá para descer ao SQL.
- Microsserviços — cobram rede, serialização, observabilidade distribuída e coordenação entre times. Compensam quando há vários times e partes do sistema que precisam evoluir e escalar de forma independente; num sistema pequeno, esse custo fixo atrasa o projeto (o que Martin Fowler chama de microservice premium).
- Reuniões diárias — cobram tempo do time. Compensam quando cumprem o propósito que o Scrum Guide dá à Daily Scrum (15 minutos para inspecionar o progresso e ajustar o plano); viram puro overhead quando se estendem e não mudam decisão nenhuma.
4. Overkill — a escolha desproporcional#
Overkill é o julgamento de que a solução é grande demais para o problema. O foco não é o custo em si, mas a relação entre a complexidade da solução e o tamanho real do problema.
Exemplos clássicos:
- Subir Kubernetes para servir um blog estático com 50 visitas por dia.
- Quebrar uma API CRUD com 3 endpoints em 8 microsserviços.
- Implementar CQRS (separar os modelos de escrita e de leitura) com Event Sourcing (guardar a sequência de eventos em vez do estado atual) num cadastro simples de clientes. O próprio Fowler alerta que, para a maioria dos sistemas, CQRS adiciona complexidade arriscada. Em domínios em que a trilha completa de eventos é requisito, como um ledger financeiro, a conta é outra.
- Usar Kafka para trocar 10 eventos por hora entre dois serviços, quando uma fila gerenciada (como o SQS) ou até uma chamada HTTP resolveria.
- Criar uma abstração genérica “para trocar de banco no futuro” num sistema que nunca vai trocar.
5. Como os dois se relacionam#
Toda solução overkill carrega overhead desnecessário, mas nem todo overhead é overkill.
| Cenário | Tem overhead? | É overkill? |
|---|---|---|
| HTTPS num e-commerce | Sim (TLS) | Não, é necessário |
| Kubernetes num blog pessoal | Sim (alto) | Sim |
| ORM num sistema de médio porte, com muito CRUD | Sim (abstração) | Não, a produtividade compensa |
| Event Sourcing num formulário de contato | Sim (enorme) | Sim |
6. Por que considerar todas as dimensões muda a conversa#
Olhando só CPU e memória, muita coisa parece “barata o suficiente”. Mas imagine somar:
- 6 meses a mais de desenvolvimento;
- 3 devs precisando entender Kafka, Saga (sequência de transações locais com ações de compensação em caso de falha) e Event Sourcing para trocar o texto de um botão;
- um incidente em produção que leva 4 horas para ser depurado porque a requisição passa por 8 serviços;
- um dev novo que leva 1 mês para abrir o primeiro PR útil.
Nesse cenário, o overhead “invisível” supera com folga qualquer ganho de performance ou de escalabilidade prometido.
É isso que John Ousterhout captura em A Philosophy of Software Design, ao definir complexidade como tudo, na estrutura de um sistema, que dificulta entendê-lo e modificá-lo. E ela é incremental: não vem de um único erro catastrófico, mas se acumula em pequenas decisões, até o sistema ficar “pesado” para evoluir, mesmo rodando rápido na máquina. Fowler descreve o mesmo efeito com a metáfora da dívida técnica: o esforço extra que cada mudança passa a exigir são os juros.
7. A analogia que fixa#
Todo carro tem overhead (combustível, manutenção, estacionamento). Usar uma Ferrari para comprar pão na esquina é overkill: você paga todo o overhead de um carro caro e a escolha em si é desproporcional ao problema.
8. Critério prático#
Na avaliação de overkill, a pergunta útil não é “isso tem overhead?” (sempre tem), mas:
“O custo total de propriedade dessa escolha pelos próximos 2–3 anos, somando runtime, desenvolvimento, carga cognitiva, manutenção, operação e organização, é proporcional ao problema que estou resolvendo?”
Quando a resposta é não, é overengineering.
E desconfie de construir “para o futuro”. É o que o princípio YAGNI (You Aren’t Gonna Need It) combate: uma funcionalidade construída por presunção cobra o custo de construí-la, atrasa o que realmente importa e, mesmo que nunca seja usada, deixa complexidade que encarece toda mudança seguinte (o cost of carry, na expressão de Fowler). Fowler ressalta que YAGNI depende de práticas que mantêm o código fácil de mudar, como testes automatizados e refatoração contínua: com elas, construir quando a necessidade for real sai mais barato do que carregar o que foi construído à toa.
Fontes#
- John Ousterhout — A Philosophy of Software Design
- Martin Fowler — Yagni
- Martin Fowler — Technical Debt
- Martin Fowler — Microservice Premium
- Martin Fowler — Microservice Trade-Offs
- Martin Fowler — CQRS
- Martin Fowler — Event Sourcing
- Martin Fowler — OrmHate
- Sandi Metz — The Wrong Abstraction
- Adam Langley — Overclocking SSL
- Oracle — Introduction to Garbage Collection Tuning (Java SE 21)
- Jeff Atwood — Hardware is Cheap, Programmers are Expensive
- Chris Richardson — Pattern: Saga
- Ken Schwaber e Jeff Sutherland — The Scrum Guide
- Wikipedia — Overengineering