 Cesar Schutz
Quando um cliente reclama de uma falha, o contexto para entender o que aconteceu costuma estar espalhado em dezenas de linhas de log, em vários serviços. Este post mostra um padrão que resolve isso: wide events (eventos “largos”), também chamados de canonical log lines, nome popularizado pela Stripe.
A ideia é simples: em vez de espalhar log.info pelo código, cada requisição emite um único evento estruturado, rico em contexto, ao final do processamento. Esse evento reúne dezenas de campos (o exemplo de Boris Tane passa de 50) com tudo que ajuda a investigar um problema: ID da requisição, dados do usuário (plano, idade da conta, valor já gasto), medidas (latência, queries, acertos de cache), feature flags ativas, contexto de negócio e o erro detalhado, quando houver.
A seguir: o problema que o padrão resolve, o vocabulário, a anatomia de um evento, uma implementação em Spring Boot, o controle de custo com tail sampling e a relação com OpenTelemetry e com o logging estruturado do Spring Boot.
1. O problema que o padrão resolve#
Como argumenta Boris Tane em Logging Sucks, o logging tradicional foi pensado para a era dos monólitos rodando em um único servidor. Hoje, uma única requisição pode passar por 15 serviços, 3 bancos de dados, 2 caches e uma fila. Mesmo assim, os logs continuam no modelo antigo: várias linhas espalhadas, cada uma com um pedaço do contexto. Quando um usuário reclama, você gasta horas fazendo grep em texto e montando o quebra-cabeça com expressões regulares frágeis.
Logging estruturado (JSON) é necessário, mas não suficiente. Sem uma disciplina de o que registrar e quando, logs em JSON ainda geram vários eventos parciais por requisição, em vez de um evento completo.
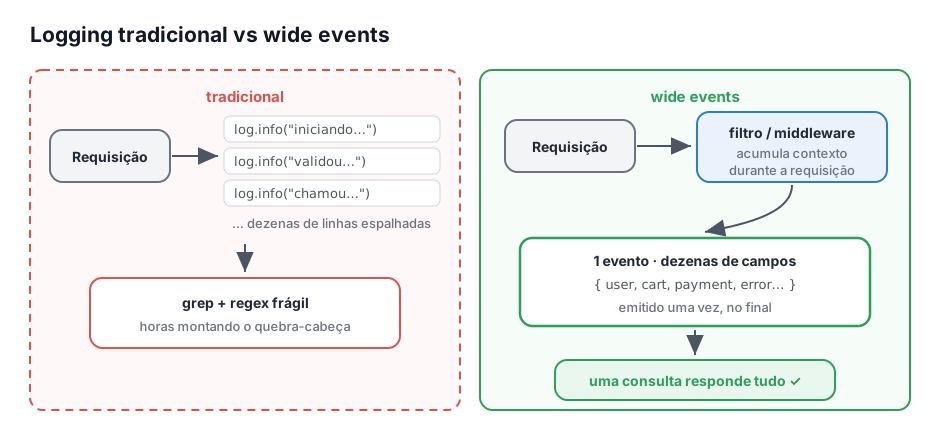
O diagrama resume a diferença: à esquerda, cada etapa escreve sua própria linha, e quem investiga precisa juntar as peças; à direita, um filtro acumula o contexto durante a requisição e emite um único evento no final, que responde à pergunta com uma só consulta.
2. Vocabulário fundamental#
- Cardinalidade — quantidade de valores distintos que um campo pode ter.
user_id(milhões de valores) tem alta cardinalidade;http_method(GET, POST, PUT, DELETE) tem baixa. Campos de alta cardinalidade são os que mais ajudam a depurar, porque permitem filtrar e agrupar por entidades reais (este usuário, este carrinho, este build). - Dimensionalidade — quantos campos cada evento carrega. 5 campos é baixa; 50 é alta. Quanto mais dimensões, mais perguntas você responde sem precisar mudar o código e fazer novo deploy.
- Wide event — evento de log denso, emitido uma vez por requisição em cada serviço, com todo o contexto relevante.
- Canonical log line — outro nome para wide event. O padrão foi descrito por Brandur Leach, engenheiro da Stripe, em 2016, e detalhado no blog de engenharia da Stripe em 2019. “Canônica” porque é a linha de referência daquela requisição.
- Observability 2.0 — termo de Charity Majors (cofundadora e CTO da Honeycomb) para a arquitetura com uma única fonte de verdade: eventos estruturados arbitrariamente largos, guardados em banco colunar. Métricas e SLOs passam a ser derivados desses eventos na hora da consulta. Contrasta com a Observability 1.0, baseada nos “três pilares” (métricas, logs e traces), cada um com sua própria fonte de verdade em ferramentas separadas.
3. Anatomia de um wide event#
Um único evento JSON descrevendo uma falha de checkout:
{ "timestamp": "2026-05-19T10:23:45.612Z", "request_id": "req_8bf7ec2d", "trace_id": "4bf92f3577b34da6a3ce929d0e0e4736", "service": "checkout-service", "version": "2.4.1", "region": "us-east-1", "method": "POST", "path": "/api/checkout", "status_code": 500, "duration_ms": 1247, "user": { "id": "user_456", "subscription": "premium", "account_age_days": 847, "lifetime_value_cents": 284700 }, "cart": { "id": "cart_xyz", "item_count": 3, "total_cents": 15999, "coupon_applied": "SAVE20" }, "payment": { "method": "card", "provider": "stripe", "latency_ms": 1089, "attempt": 3 }, "error": { "type": "PaymentError", "code": "card_declined", "stripe_decline_code": "insufficient_funds", "retriable": false }, "feature_flags": { "new_checkout_flow": true, "express_payment": false }}Uma única consulta por user.id = "user_456" já mostra: cliente premium, mais de 2 anos de conta, falha na 3ª tentativa de pagamento, motivo real da recusa (insufficient_funds) e uso do novo fluxo de checkout. Sem grep e sem buscas em vários serviços. O trace_id liga o evento ao trace distribuído da operação (veja W3C Trace Context).
4. Implementação prática com um filtro HTTP#
O segredo é construir o evento ao longo da requisição em um ponto central (middleware) e emiti-lo uma única vez, no final. No Spring Boot, isso cabe em um OncePerRequestFilter: ele cria o evento, deixa os services o enriquecerem com contexto de negócio e escreve o log no finally.
@Componentpublic class CanonicalLogFilter extends OncePerRequestFilter {
    private static final String EVENT_ATTRIBUTE = "canonical_event";    private static final Logger log = LoggerFactory.getLogger("canonical");
    @Override    protected void doFilterInternal(HttpServletRequest req, HttpServletResponse res, FilterChain chain)            throws ServletException, IOException {        Map<String, Object> event = new LinkedHashMap<>();        event.put("request_id", UUID.randomUUID().toString());        event.put("method", req.getMethod());        event.put("path", req.getRequestURI());        req.setAttribute(EVENT_ATTRIBUTE, event);        long start = System.nanoTime();        try {            chain.doFilter(req, res);        } catch (IOException | ServletException | RuntimeException e) {            // a exceção ainda não virou resposta: o status seria 200 se lido agora            event.put("status_code", 500);            event.put("error.type", e.getClass().getSimpleName());            event.put("error.message", e.getMessage());            throw e;        } finally {            try {                event.putIfAbsent("status_code", res.getStatus());                event.put("duration_ms", (System.nanoTime() - start) / 1_000_000);                var line = log.atInfo();                event.forEach(line::addKeyValue); // cada entrada vira um campo do JSON                line.log("request.completed");            } catch (RuntimeException ignored) {                // falha ao montar o log nunca derruba a requisição            }        }    }
    /** Chamado pelos services para enriquecer o evento da requisição atual. */    @SuppressWarnings("unchecked")    public static void add(String key, Object value) {        RequestAttributes attrs = RequestContextHolder.getRequestAttributes();        if (attrs != null                && attrs.getAttribute(EVENT_ATTRIBUTE, RequestAttributes.SCOPE_REQUEST) instanceof Map<?, ?> event) {            ((Map<String, Object>) event).put(key, value);        }    }}
Nos services, o enriquecimento é uma linha, por exemplo CanonicalLogFilter.add("cart.total_cents", cart.totalCents()). A emissão usa a API fluente do SLF4J 2 (addKeyValue): tanto o structured logging nativo do Spring Boot (formatos ECS, GELF e Logstash) quanto o LogstashEncoder escrevem cada par chave-valor como um campo do JSON. Com o LogstashEncoder, uma requisição que lança exceção sai assim (campos de metadados omitidos):
{"message":"request.completed","logger_name":"canonical","level":"INFO","request_id":"29bd9de2-e60c-45ff-bc95-4ea87c339183","method":"POST","path":"/api/checkout","status_code":500,"error.type":"IllegalStateException","error.message":"boom","duration_ms":0}As duas proteções do código vêm da implementação original da Stripe, em Ruby: a linha é emitida num bloco ensure (o equivalente ao finally), para sair mesmo quando uma exceção sobe pela pilha, e a própria montagem do log fica dentro de um begin/rescue, para que um erro ao construir a linha nunca derrube a requisição.
Cuidados:
RequestContextHolderguarda a requisição na thread atual. Trabalho feito em outra thread (@Async,CompletableFuture) não enxerga o evento, a menos que você passe o contexto adiante.- Um evento com dados de usuário é um bom lugar para vazar dados pessoais. Registre identificadores e atributos úteis para investigação, não documentos, e-mails ou dados de cartão.
5. Tail sampling para controlar o custo#
Dezenas de campos por evento, multiplicados por milhares de requisições por segundo, podem estourar o orçamento de observabilidade. A saída óbvia, descartar uma fração aleatória das requisições logo na entrada (head sampling), é arriscada: pode jogar fora justamente a requisição que explica o incidente.
Tail sampling decide depois que a requisição termina, olhando o resultado. As regras sugeridas por Boris Tane:
- Guardar 100% dos erros (status 5xx, exceções, falhas).
- Guardar todas as requisições lentas, acima do p99 de latência.
- Guardar sempre usuários específicos: clientes VIP, contas internas de teste, sessões marcadas para investigação.
- Guardar uma amostra aleatória de 1% a 5% do restante.
Com wide events, a decisão pode ficar no próprio filtro, antes de emitir o log. Para traces, o OpenTelemetry Collector oferece o tail sampling processor, que aplica regras desse tipo (erros, latência, atributos) no pipeline de telemetria.
6. Por que OpenTelemetry sozinho não resolve#
O OpenTelemetry (OTel) é um framework para gerar, coletar e exportar telemetria: APIs, SDKs, o protocolo OTLP e o Collector. Ele padroniza como a telemetria é produzida e transportada, mas não decide o que entra no evento nem acrescenta contexto de negócio. Se você não registrar o plano do usuário, o valor do carrinho ou as feature flags ativas, o OTel não vai adivinhar. Idealmente, seus wide events são os próprios spans do trace, enriquecidos com todo o contexto necessário, em vez de dados duplicados em formatos separados.
7. Conexão com o logging estruturado do Spring Boot#
O LogstashEncoder e o structured logging nativo do Spring Boot 3.4 entregam a infraestrutura: JSON, campos do MDC e pares chave-valor como campos indexáveis (detalhes em Logging estruturado em Spring Boot). Wide events são a disciplina construída sobre essa base: em vez de espalhar log.info pelo código de negócio, você concentra a emissão num filtro que acumula contexto durante o processamento e emite um único evento completo no final. O JSON sai pelo mesmo pipeline (ECS, Logstash, GELF); muda o que e quando você emite, não como.
Fontes#
- Boris Tane — Logging Sucks
- Brandur Leach — Using Canonical Log Lines for Online Visibility (2016)
- Stripe Engineering (Brandur Leach) — Fast and Flexible Observability with Canonical Log Lines (2019)
- Charity Majors / Honeycomb — It’s Time to Version Observability
- Charity Majors / Honeycomb — One Key Difference Between Observability 1.0 and 2.0
- Honeycomb — Charity Majors, CTO
- Spring Boot Reference — Structured Logging
- logstash-logback-encoder — Key Value Pair Fields
- SLF4J — Fluent Logging API
- OpenTelemetry — What is OpenTelemetry?
- OpenTelemetry — Sampling
- OpenTelemetry Collector Contrib — Tail Sampling Processor