 Cesar Schutz
Rotinas agendadas no Kubernetes costumam sofrer com três problemas clássicos: execuções duplicadas, novas tentativas perigosas e jobs travados. Alguns campos de CronJob e Job existem justamente para evitá-los. Este post explica cada um, com seus valores padrão, mostra como eles se combinam numa configuração conservadora e aponta o que continua sendo responsabilidade da aplicação.
O contexto#
Três objetos participam de uma rotina agendada:
- O CronJob guarda o agendamento (
schedule, em sintaxe cron) e, a cada horário, cria um Job. - O Job cria um ou mais Pods e acompanha a execução até ela terminar com sucesso ou falha.
- O Pod é quem de fato roda o container da rotina.
Cada campo deste post pertence a um desses níveis:
concurrencyPolicy: Forbid # CronJobstartingDeadlineSeconds: 60 # CronJobjobTemplate: spec: # Job activeDeadlineSeconds: 300 backoffLimit: 0 template: spec: # Pod restartPolicy: NeverEles controlam três coisas:
- Se uma nova execução pode começar enquanto a anterior ainda está rodando.
- Até quando o Kubernetes aceita iniciar uma execução atrasada.
- O que acontece quando o job falha ou demora demais.
Isso importa principalmente quando o processamento altera dados, envia eventos, faz conciliação, processa pagamentos ou recalcula saldos, tarefas que não devem produzir o mesmo efeito duas vezes.
concurrencyPolicy: Forbid#
Pertence ao CronJob. Define o que fazer quando chega o horário de uma nova execução e o Job anterior ainda não terminou:
Allow(padrão): permite Jobs simultâneos.Forbid: pula a nova execução enquanto a anterior estiver ativa.Replace: encerra o Job em andamento e cria o novo no lugar dele.
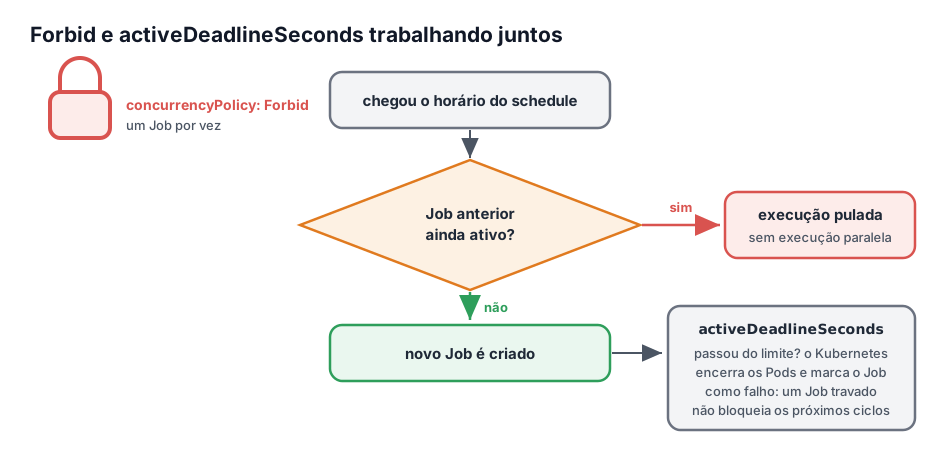
Com Forbid, a regra é “se o Job anterior ainda está rodando, não inicia outro”. É a opção mais segura quando a rotina não pode rodar duas vezes ao mesmo tempo.
Exemplo prático: um job de conciliação roda a cada 10 minutos. Se uma execução demorar 15 minutos com o padrão Allow, duas conciliações rodam juntas, com risco de duplicidade, disputa pelos mesmos dados e processamento fora de ordem. Com Forbid, a execução das 10:10 é pulada enquanto a das 10:00 estiver ativa.
Um detalhe: a política vale só para os Jobs criados pelo mesmo CronJob. Dois CronJobs diferentes que chamam a mesma rotina continuam podendo rodar em paralelo.
activeDeadlineSeconds#
Pertence ao Job. Define por quanto tempo o Job pode ficar ativo. Com 300, são no máximo 5 minutos; passou disso, o Kubernetes encerra todos os Pods do Job e marca o Job como falho (condição Failed, motivo DeadlineExceeded). Não há padrão: se o campo não for definido, o Job não tem limite de tempo.
Dois cuidados:
- O tempo conta a partir do início do Job (campo
status.startTime), não do container, e vale para o Job inteiro, não importa quantos Pods ele crie. Tempo esperando o Pod ser agendado ou a imagem ser baixada também entra na conta. - Encerrar o Pod segue o ciclo normal de término: o container recebe SIGTERM e, se não sair dentro do prazo de tolerância, SIGKILL. Detalhes em SIGTERM e SIGKILL — o ciclo de término de um pod no Kubernetes.
Este campo é o complemento indispensável do Forbid: se um Job travar e nunca terminar, o Forbid pula todos os ciclos seguintes. Sem activeDeadlineSeconds, um único Job travado bloqueia a agenda inteira.
schedule: "*/10 * * * *"concurrencyPolicy: ForbidjobTemplate: spec: activeDeadlineSeconds: 300Leitura prática: “rode a cada 10 minutos, e cada execução dura no máximo 5. Se travar, o Kubernetes encerra, e uma execução presa não bloqueia as próximas.”
Atenção ao nível: o spec do Pod também tem um campo activeDeadlineSeconds. O que limita a execução inteira é o do spec do Job (jobTemplate.spec).
startingDeadlineSeconds#
Pertence ao CronJob. Define por quantos segundos, depois do horário agendado, o Kubernetes ainda aceita criar o Job. Com 60: “se estava agendado para 10:00, o Job só pode ser criado até 10:01; depois disso, a execução é pulada”. As próximas continuam agendadas normalmente. Não há padrão: sem o campo, uma execução atrasada não tem prazo para começar.
Exemplo prático: um job deveria rodar às 02:00, numa janela controlada de processamento. Se o cluster ficou instável e o controller só conseguiu criar o Job às 02:30, talvez não faça mais sentido rodar. O startingDeadlineSeconds impede a execução fora da janela.
Ele também conversa com o Forbid. Quando o Job anterior termina, o controller ainda tenta criar a execução que foi pulada, desde que ela esteja dentro do startingDeadlineSeconds. No exemplo da conciliação: se a execução das 10:00 terminar às 10:15 e não houver startingDeadlineSeconds, a execução das 10:10 começa logo em seguida, fora de hora. Com 60, ela é descartada e a próxima roda às 10:20.
Cuidados:
- Não use valor menor que 10 segundos: o controller de CronJob verifica os agendamentos a cada 10 segundos e pode perder a janela.
- Sem
startingDeadlineSeconds, se o controller perder mais de 100 horários desde a última execução (por exemplo, por ficar fora do ar), ele não cria o Job e registra o errotoo many missed start times. Com o campo definido, a contagem considera só os horários perdidos dentro dessa janela.
timeZone#
Pertence ao CronJob e é estável desde o Kubernetes 1.27. Sem ele, o schedule é interpretado no fuso horário do processo kube-controller-manager, que nem sempre é o que você imagina. Para uma janela como “02:00 no horário de Brasília”, declare o fuso explicitamente com um nome da base de fusos IANA:
schedule: "0 2 * * *"timeZone: "America/Sao_Paulo"Não use CRON_TZ= ou TZ= dentro do schedule: o Kubernetes rejeita o recurso com erro de validação.
backoffLimit#
Pertence ao Job. Define quantas novas tentativas o Kubernetes faz depois de uma falha antes de marcar o Job como falho. O padrão é 6. Com backoffLimit: 3, o Job aceita até 3 novas tentativas, com intervalo crescente entre elas (10 s, 20 s, 40 s… limitado a 6 minutos).
Com backoffLimit: 0, o comportamento fica rígido: “falhou uma vez, acabou”. Isso é útil quando uma nova tentativa automática pode causar problema:
- Reprocessar o mesmo arquivo.
- Enviar a mesma mensagem duas vezes.
- Recalcular uma operação sensível.
- Tentar de novo sem saber se a execução anterior falhou antes ou depois de gravar dados.
Em jobs sensíveis, muitas vezes é melhor falhar de forma clara, gerar log e alerta e deixar uma pessoa (ou um processo controlado) decidir o reprocessamento. O activeDeadlineSeconds tem prioridade sobre o backoffLimit: ao atingir o tempo limite, o Job falha mesmo que ainda restem tentativas.
restartPolicy: Never#
Pertence ao template do Pod. Num Pod comum, o padrão é Always, mas em Jobs esse valor não é aceito: só Never ou OnFailure, e por isso o campo precisa ser declarado.
OnFailure: quando o container falha, ele é reiniciado dentro do mesmo Pod. Esses reinícios também contam para obackoffLimit.Never: o container que falha não é reiniciado; o Pod termina como falho e quem decide se haverá nova tentativa (um Pod novo) é o Job, respeitando obackoffLimit.
A combinação restartPolicy: Never + backoffLimit: 0 dá o comportamento mais previsível: “o container falhou, o Pod falhou, o Job falhou. Não tenta de novo.” Nenhuma nova tentativa automática escondida. A própria documentação sugere Never ao depurar Jobs: com OnFailure, o Pod é encerrado quando o limite de tentativas é atingido, o que dificulta ler a saída da execução.
Como trabalham juntos#
apiVersion: batch/v1kind: CronJobmetadata: name: exemplo-processamentospec: schedule: "*/10 * * * *" timeZone: "America/Sao_Paulo" concurrencyPolicy: Forbid startingDeadlineSeconds: 60 jobTemplate: spec: activeDeadlineSeconds: 300 backoffLimit: 0 template: spec: restartPolicy: Never containers: - name: processamento image: minha-imagem:1.0.0Em português claro:
- Rode a cada 10 minutos, no horário de Brasília.
- Não deixe duas execuções rodarem ao mesmo tempo.
- Se o Job não puder ser criado em até 60 segundos após o horário, pule aquela execução.
- Cada execução dura no máximo 5 minutos.
- Se falhar, não tente novamente.
- Se o container cair, não reinicie dentro do mesmo Pod.
O que esses campos não garantem#
Essa configuração reduz muito o risco, mas não elimina a duplicidade. A documentação do Kubernetes avisa que:
- O CronJob cria um Job aproximadamente uma vez por horário: em certas circunstâncias, pode criar dois ou nenhum.
- Mesmo com um único Pod por Job e
restartPolicy: Never, o mesmo programa pode, às vezes, ser iniciado duas vezes.
Por isso, a recomendação oficial é que os Jobs sejam idempotentes, ou seja, que rodar duas vezes produza o mesmo resultado que rodar uma. Na prática, a proteção final fica na aplicação: chave de idempotência, restrição única no banco ou um bloqueio que impeça dois processamentos do mesmo lote. Os posts Cobrança duplicada no retry e Bloqueio otimista e pessimista mostram essas técnicas.
Também vale preparar a rotina para ser encerrada no meio (pelo activeDeadlineSeconds ou porque o nó foi reiniciado ou removido): tratar o SIGTERM e não deixar estado pela metade, como em AtomicBoolean — o sinalizador thread-safe da parada graciosa.
Resumo#
| Campo | Onde fica | Padrão | Para que serve |
|---|---|---|---|
concurrencyPolicy | CronJob | Allow | Controla se pode haver mais de um Job simultâneo |
startingDeadlineSeconds | CronJob | sem prazo | Até quando uma execução atrasada ainda pode começar |
timeZone | CronJob | fuso do kube-controller-manager | Fuso horário em que o schedule é interpretado |
activeDeadlineSeconds | Job | sem limite | Tempo máximo de uma execução |
backoffLimit | Job | 6 | Quantas novas tentativas após falha |
restartPolicy | template do Pod | obrigatório em Jobs (Never ou OnFailure) | Se o container reinicia dentro do mesmo Pod |
O ponto mais importante#
O campo mais crítico do conjunto é o activeDeadlineSeconds. Sem ele, um job pode ficar travado indefinidamente, e com concurrencyPolicy: Forbid esse job travado impede todos os ciclos seguintes. A regra prática:
Se usar
concurrencyPolicy: Forbid, defina tambémactiveDeadlineSeconds.
Fontes#
- Kubernetes — CronJob
- Kubernetes — Jobs
- Kubernetes — Referência da API: CronJob (batch/v1)
- Kubernetes — Referência da API: Job (batch/v1)
- Kubernetes — Pod Lifecycle: término de Pods