 Cesar Schutz
Todo deploy, redução de réplicas ou drenagem de nó encerra pods. Se a aplicação não souber sair direito, cada uma dessas operações derruba requisições em andamento, deixa transações pela metade e conexões penduradas no banco. O Kubernetes encerra containers com dois sinais Unix: o SIGTERM (sinal 15), um pedido de término que o processo pode tratar, e o SIGKILL (sinal 9), um abate forçado que não pode ser tratado.
Este post mostra o ciclo de término de um pod passo a passo, a condição de corrida entre a rede e o SIGTERM (e como o preStop a resolve), os exit codes que ajudam no diagnóstico, como configurar o graceful shutdown do Spring Boot dentro do prazo do Kubernetes e o erro de Dockerfile que faz o app nunca receber o SIGTERM.
Os dois sinais#
SIGTERM(15) — sinal que o processo pode capturar. Ao recebê-lo, a aplicação faz um graceful shutdown (encerramento gracioso): para de aceitar conexões novas, termina as requisições em andamento, fecha conexões com o banco, libera locks distribuídos e grava buffers e métricas pendentes.SIGKILL(9) — sinal que não pode ser capturado, bloqueado nem ignorado. O kernel encerra o processo na hora e nenhuma rotina de limpeza roda. O risco é perder dados, deixar conexões órfãs no banco e transações pela metade.
O ciclo de término de um pod#
Um pod entra em Terminating quando é apagado: delete manual, rolling update, redução de réplicas, drenagem de nó (kubectl drain), eviction (despejo do pod pelo cluster) ou um Job que atingiu o activeDeadlineSeconds (veja o post sobre CronJob e tempo máximo de execução). Nesse momento, o API server registra o prazo de término e duas trilhas começam em paralelo:
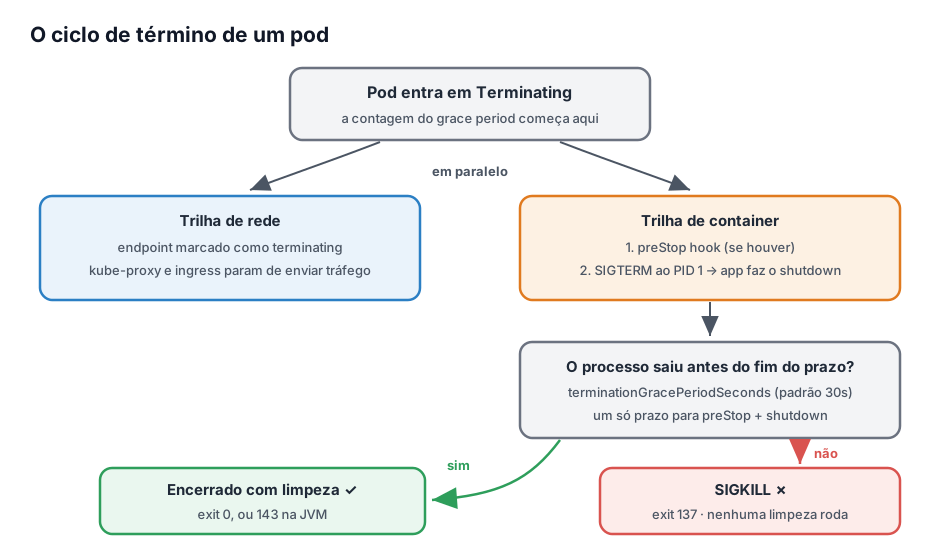
- Começa a contagem do
terminationGracePeriodSeconds(padrão de 30s). Ela começa antes dopreStop, e não depois doSIGTERM: o mesmo prazo cobre opreStope o shutdown do app. É um orçamento único, não um tempo a mais para cada etapa. - Trilha de rede — o endpoint do pod no EndpointSlice (o objeto que lista os IPs por trás de um Service) é marcado como terminating e deixa de ser
ready. kube-proxy, ingress controllers e load balancers param de enviar tráfego novo ao pod, cada um no seu tempo. - Trilha de container — o kubelet executa o
preStophook, se houver, e só depois que ele termina manda oSIGTERMao processo principal (PID 1) de cada container. Se a imagem definir outro sinal com a instruçãoSTOPSIGNAL, os runtimes costumam enviar esse sinal no lugar doSIGTERM. - Fim do prazo — se algum container ainda estiver rodando quando o grace period acabar, o runtime envia
SIGKILL. Se opreStopainda estiver rodando nessa hora, o kubelet concede uma única extensão de 2 segundos antes de forçar.
Se o processo sair antes do fim do prazo, o Kubernetes não espera o restante: o pod é finalizado na hora.
A condição de corrida com os endpoints#
Como as duas trilhas são paralelas, há uma race condition (condição de corrida): durante alguns segundos o app já recebeu o SIGTERM e começou a se desmontar, mas o ingress ou o load balancer ainda não soube que o pod está saindo e continua mandando requisições para ele. Essas requisições falham.
A prática recomendada, inclusive pela documentação do Spring Boot, é um preStop que apenas espera alguns segundos antes do SIGTERM. A partir do Kubernetes 1.30 existe a ação sleep nativa (estável desde a 1.34), que não depende de shell na imagem:
spec: terminationGracePeriodSeconds: 60 containers: - name: app image: my-app:1.0.0 lifecycle: preStop: sleep: seconds: 15Em clusters mais antigos, a alternativa é executar o sleep pelo shell. Ela só funciona se a imagem tiver sh e sleep (imagens distroless, sem shell, não têm):
lifecycle: preStop: exec: command: ["/bin/sh", "-c", "sleep 15"]O sleep não drena conexões: ele só atrasa o SIGTERM, dando tempo para o tráfego novo parar de chegar antes de o app começar a se desmontar. Não há um valor universal. Os 15s do exemplo são um ponto de partida: meça quanto tempo o seu ingress ou load balancer leva para tirar o pod da rotação.
Exit codes úteis para diagnóstico#
Quando um processo morre por causa de um sinal, o código de saída segue a convenção 128 + número do sinal. Ele aparece no status do container (kubectl describe pod, nos campos State e Last State) e nas ferramentas de monitoramento:
0— o processo terminou por conta própria com sucesso (chamouexit(0)).143(128 + 15) — o processo terminou por causa doSIGTERM. Numa aplicação Java, esse é o resultado normal de um shutdown gracioso: a JVM executa os shutdown hooks (é assim que o Spring fecha o contexto) e depois sai com 143. Não indica falha.137(128 + 9) — o processo foi morto porSIGKILL. As causas típicas são grace period estourado,OOMKilled(o container passou do limite de memória e o kernel o matou) ou um delete forçado.
Um 137 com o motivo OOMKilled aponta para memória; um 137 sem esse motivo, logo após um deploy, costuma indicar que o shutdown não coube no grace period.
Spring Boot — graceful shutdown nativo#
O Spring Boot suporta graceful shutdown desde a versão 2.3, e desde a 3.4 ele vem ativado por padrão. No Spring Boot 4 ele funciona com os três servidores web embarcados suportados: Tomcat, Jetty e Reactor Netty. O Undertow deixou de ser suportado no Spring Boot 4; nas versões 2.3 a 3.x ele também tinha graceful shutdown, mas respondia 503 às requisições novas em vez de recusá-las na camada de rede.
server: shutdown: graceful # já é o padrão desde o Spring Boot 3.4spring: lifecycle: timeout-per-shutdown-phase: 25s # padrão: 30sAo receber SIGTERM, a JVM dispara o shutdown hook do Spring, que fecha o ApplicationContext. Nesse processo:
- O servidor web para de aceitar novas requisições na camada de rede.
- As requisições em andamento têm até
timeout-per-shutdown-phasepara terminar. Como o nome diz, esse limite vale por fase de encerramento, e não para o shutdown inteiro. - O contexto termina de fechar: pools de conexão, schedulers e os métodos
@PreDestroydos beans.
Atenção ao testar localmente: parar o app pela IDE pode encerrar o processo sem mandar um SIGTERM de verdade, e aí o shutdown não é gracioso.
Limpeza adicional com @PreDestroy#
Para liberar recursos próprios (um ExecutorService, locks, conexões criadas à mão), basta um método anotado com @PreDestroy. O Spring o chama no passo 3, durante o fechamento do contexto:
@Componentpublic class JobWorker {    private final ExecutorService executor = Executors.newFixedThreadPool(8);
    @PreDestroy    public void shutdown() {        executor.shutdown();                  // não aceita tarefas novas        try {            if (!executor.awaitTermination(10, TimeUnit.SECONDS)) {                executor.shutdownNow();       // interrompe o que sobrou            }        } catch (InterruptedException e) {            executor.shutdownNow();            Thread.currentThread().interrupt();        }    }}
Esse tempo de espera (até 10s aqui) soma-se ao tempo do servidor web e também precisa caber no grace period.
Para jobs longos fora da camada web, o padrão clássico é um shutdown hook registrado com Runtime.getRuntime().addShutdownHook(...) que liga um AtomicBoolean stopping. O loop de trabalho confere essa flag a cada iteração e encerra no próximo ponto seguro. O post AtomicBoolean — o sinalizador thread-safe da parada graciosa detalha esse padrão.
Sintonia entre Spring e Kubernetes#
O shutdown completo do Spring precisa caber no grace period do Kubernetes, que também cobre o preStop. Some o pior caso de cada etapa e deixe uma folga:
preStop + requisições web + @PreDestroy + folga ≤ terminationGracePeriodSeconds 15s + 25s + 10s + 5s = 55s ≤ 60sSe a soma passar do terminationGracePeriodSeconds, o Kubernetes manda SIGKILL no meio do shutdown, exatamente o que se queria evitar. Ao aumentar o timeout-per-shutdown-phase, aumente também o grace period.
A pegadinha do PID 1#
O kubelet manda o SIGTERM só ao PID 1 do container. Para o Spring recebê-lo, o processo java precisa ser o PID 1 ou receber o sinal repassado por ele. O erro clássico está no ENTRYPOINT:
# ❌ ERRADO — o sh vira PID 1 e não repassa o SIGTERM ao javaENTRYPOINT ["sh", "-c", "java -jar /app.jar"]
# ❌ ERRADO — a forma shell é equivalente a /bin/sh -c "..."ENTRYPOINT java -jar /app.jar
# ✅ CORRETO — forma exec: o java é o PID 1ENTRYPOINT ["java", "-jar", "/app.jar"]
Nos dois primeiros casos, o sh é o PID 1, recebe o SIGTERM e não o repassa ao processo filho java. Nenhum shutdown hook dispara, o graceful shutdown nunca acontece e o app só morre com o SIGKILL ao fim do grace period (exit 137). Alguns shells trocam a si mesmos pelo comando quando ele é o único da linha, mas o sh de imagens comuns, como a eclipse-temurin, não faz isso. Não conte com esse comportamento.
Quando um script de entrada é mesmo necessário (para montar variáveis ou preparar arquivos, por exemplo), termine-o com exec, que substitui o shell pelo java e o torna o PID 1:
#!/bin/shexport JAVA_OPTS="-XX:MaxRAMPercentage=75"exec java $JAVA_OPTS -jar /app.jarOutra opção é usar um init mínimo como o tini como PID 1, executando o java diretamente (ENTRYPOINT ["tini", "--", "java", "-jar", "/app.jar"]): ele repassa os sinais ao filho e recolhe processos zumbis.
Quando o SIGTERM não dá conta#
kubectl delete pod --grace-period=0 --force— o API server apaga o pod na hora, sem esperar confirmação do nó. No nó, o processo ainda recebe um prazo mínimo antes de ser morto, mas o app não tem tempo real de encerrar. E como o objeto some antes de o container parar, um pod novo com o mesmo nome pode subir enquanto o antigo ainda roda. Use só em emergência, como um pod travado emTerminating.OOMKilled— o kernel mata o container que passou do limite de memória comSIGKILL. Não háSIGTERMnem grace period.- Eviction por pressão no nó — quando falta memória ou disco, o kubelet despeja pods sem respeitar o
terminationGracePeriodSecondsdo pod: com limites hard o encerramento é imediato (grace period de 0s); com limites soft vale o máximo configurado no kubelet (eviction-max-pod-grace-period). - Falha do nó — se a máquina cai, nenhum sinal é enviado.
Por isso, mesmo com um tratamento de SIGTERM perfeito, o app precisa tolerar morte súbita: operações idempotentes (que podem ser repetidas sem efeito duplicado), locks com TTL (expiração automática), transações curtas e processamento em lotes que fazem commit em pedaços.
Fontes#
- Kubernetes — Pod Lifecycle: Termination of Pods
- Kubernetes — Container Lifecycle Hooks
- Kubernetes — Feature Gates (
PodLifecycleSleepAction) - Kubernetes — Node-pressure Eviction
- Kubernetes — Assign Memory Resources to Containers and Pods (OOMKilled, exit 137)
- Spring Boot — Graceful Shutdown
- Spring Boot — Deploying to the Cloud: Kubernetes Container Lifecycle
- Spring Boot — Release Notes 3.4 (graceful shutdown por padrão)
- Spring Boot — Issue #46917: remoção do suporte ao Undertow
- Linux man-pages — signal(7)
- GNU Bash Manual — Exit Status (128 + N)
- Docker — Dockerfile reference: ENTRYPOINT
- tini — krallin/tini
- Google Cloud — Kubernetes best practices: terminating with grace
- CNCF — Decoding the pod termination lifecycle
- Baeldung — Web Server Graceful Shutdown in Spring Boot